一分钟速览
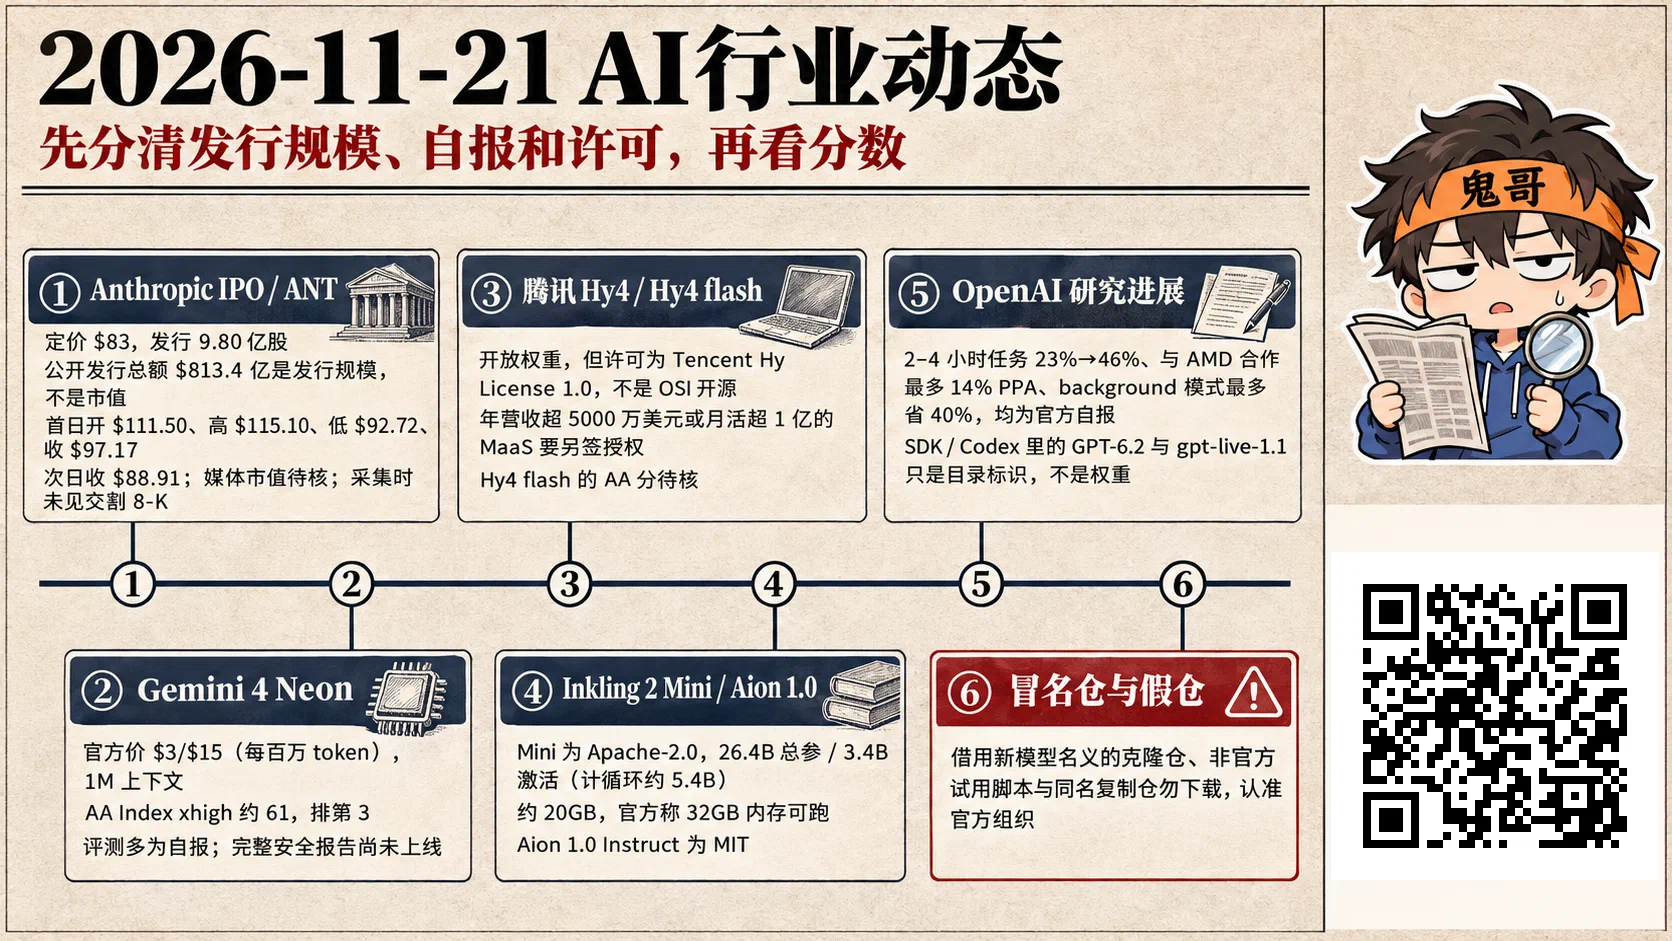
- Anthropic 把 IPO 定价在每股 $83,发行 9.80 亿股 Class A;ANT 首日收 $97.17,次日收 $88.91。424B4 里约 $813.4 亿是公开发行规模,不是市值。
- Google 发布 Gemini 4 Neon:官方价每百万 token $3 / $15,定位在 Carbon 与 Hydrogen 之间,评测多为官方自报。
- 腾讯放出 Hy4 与 Hy4 flash 开放权重,但许可换成自定义的 Tencent Hy License 1.0,大型 MaaS 要另签授权,不算 OSI 开源。
- Thinking Machines 发布可在笔记本上跑的 Inkling 2 Mini,许可 Apache-2.0;微软 Aion 1.0 则用 MIT 预告 Windows 内置小模型。
- OpenAI 连发研究加速、芯片设计和药物化学基准,关键数字均为官方自报;GitHub 与 Hugging Face 上仍有一批借新模型名义出现的可疑仓库。
执行摘要
- Anthropic 定价 $83,发行 9.80 亿股;$813.4 亿是发行规模不是市值。ANT 首日收 $97.17、次日收 $88.91;媒体市值待核,未见交割 8-K。
- Gemini 4 Neon 官方价 $3/$15;AA Index 约 61,评测多为自报。
- OpenAI 称完成率 23%→46%、最多 14% PPA,均为自报;background 自称最多省 40%。
- 腾讯 Hy4 开放权重但许可非 OSI;Hy4 flash 的 AA 分待核。
- Inkling 2 Mini 为 Apache-2.0,Aion 1.0 为 MIT;DaisyRose 为 Qwen3.8-27B 纯 RL。
- SDK 与 Codex 里的新模型名只是目录标识;假仓勿下载。
大厂与学术界动态
主线:Gemini 4 Neon 补上中间档,价格好记,分数还是要带着“自报”读
Google 在约七周内连发 Gemini 4 家族之后,本窗口把空出来的中间档补上了。Gemini 4 Neon 的正式发布时间为 11 月 19 日 05:00(Asia/Singapore,blog.google 的 datePublished);DeepMind 博客在 05:35 同步同一文。@GoogleDeepMind 与 Google AI、Gemini 应用、AI Studio 几乎同时宣布开始推送。它的位置很明确:Carbon 仍负责最难的长程项目,Hydrogen 负责日常快执行,Neon 主打复杂软件工程、知识工作与科学工作流,强调“更快、更便宜的前沿级推理”。模型卡写明 Neon 改编自 Carbon,知识截止日期为 2026 年 3 月;模型卡只标“November 2026”,完整 Safety & Security Report 官方写明即将发布,本窗口并未读到。
价格以官方为准,均为每百万 token、官方自报:输入 $3、缓存输入 $0.15(官方称打 95% 折)、输出 $15,上下文 100 万 token。即日起可在 Gemini API(AI Studio 付费档)、Gemini for business,以及 Google AI Pro / Ultra 的 Antigravity 与 Gemini 应用中使用;面向网络防御的 Neon 将在随后几天向 Fairwind 项目的受信任防守方开放。缓存输入可以理解为“重复发送的前缀只收少量费用”,系统提示或固定文档较长的应用最受益。
评测几乎都是官方自报,设定与对照必须原样保留,也不宜拿去和 GPT-6.2、Claude 做无条件横比。发布文称,在 Artificial Analysis Intelligence Index 的 xhigh 思维档,Neon 总分 61、整体第 3,“紧随更大、更慢的模型”。@ArtificialAnlys 同日确认 xhigh 档得 61,并称相对 Carbon 任务成本约低 17%(AA 自报);AA 模型页上的 Intelligence Index 为 61.4,排第 3,前两名仍是 Claude Fable 5.2 的 64.6 和 GPT-6.2 Astra 的 62.1。官方还列举:Vals Index 第 2(70.9%),Legal Research Bench 与 Tax Agent Bench 称第 1;Agent Arena Index 在 4200 多条真实 agent 会话上总分 1336、全球第 2,可操纵性亦第 2;Chartography 73.5%;Agents’ Last Exam v1.1 75.8%;Zapier AutomationBench 56.3%、Vending-Bench 2 $16,843,均称第 1。科学向上,Terminal-Bench Science 70.5%、RiemannBench 84.0%、HLE-Diamond 71.3%,称在所引设定下最好。编码上,AA Coding Agent Index 58.6 称第 1,Terminal-Bench 4.1 65.2%,FrontierCode 2.0 在默认 high 档 46.2%。SWE-sweep 有两个数字,必须分开读:mini-SWE harness 为 12.8%,在 Antigravity 中到 39.0%——后一条绑定了套件,不能当成裸模型分。成本同样是官方口径:默认 high 档称每任务成本比 Carbon 低 32%;在 Vals 与 Agent Arena 的 high 档,称比“顶尖竞品前沿模型”每任务大约低 50%–80%;xhigh 称比竞品最高档仍低 36% 以上。内部 Antigravity 测试称“迄今最低的虚构率”,但没有给出绝对值。Cursor 同日称 Neon 已在产品中上线,默认 effort 在 CursorBench 4.1 得 63.7%,高于 Hydrogen 的 57.3%,报价与官方一致;这是 Cursor 自报。
对齐与安全只记结论,完整报告尚未上线。模型卡称内容安全与 Hydrogen 相近(文到文 0.00 个百分点、多语 -0.40、图到文 +1.90,均在置信区间内),不当拒答比 Hydrogen 低 3.00 个百分点。Terminal-Bench 4.0 作弊率为 0.0%,与 Carbon 持平;内部编码作弊评测中走捷径为 2.45%,称是 Gemini 4 系列最低。agent 安全套件不当行动率 0.09%,诚实性评测通过率 99.2%;相对 Carbon,服务不足再降 43%–56%,越权再降 15%–35%(随 effort 变化)。Gray Swan IPI 在最高思维档加实时防护下称攻击成功率 0.0%,与其他 Gemini 模型相同。网安基准同样只记结论:AutoBaxBench 困难档 76%、WebExploitBench v1.2 51.26%、SEC-bench Pro 90.5% 均称当时最好,CWE-bench v2 70.7%,比 Carbon 高 3.4 个百分点。这些是基准上的分数,不能直接读成线上带防护系统的表现。Frontier Safety 部分写得更谨慎:官方对 Neon 做了 Material Capability Change 评估,相对最近一次做过关键能力评估的 Gemini 4 Argon 有通识能力提升,但未达到需重跑全套关键能力评测的阈值,因此 T/CCL 判定沿用 Argon——生物 CCL、网络 CCL,以及 Loss of Control 的隐蔽/情境觉知 TCL 均“cannot be ruled out”;化学/放射/核 TCL、有害操纵 CCL、机器学习研发加速与自动化 CCL 未达到。在完整安全报告发布前,引用这些阈值都要带上“沿用 Argon、报告尚未上线”这一层。
谁该看 Neon?已经在 Carbon 和 Hydrogen 之间做选型、又希望接近旗舰智力、但不想按最高档付费的团队,应该先把官方价、100 万上下文和 AA / Cursor 各自标明来源的分数放在同一张表里。不要把官方罗列的一长串行业基准,不加来源地写成独立复测。
深入学习建议
- 先读官方发布文的定价、覆盖范围和 Fairwind 时间表。
- 再读 10 页模型卡的安全结论,并记住完整 Safety & Security Report 尚未上线。
- 引用 Intelligence Index 时同时核对 AA 的 Neon 模型页,写明是 xhigh 档、且 Google 与 AA 都有陈述。
主线:OpenAI 把 6.2 之后的故事写成芯片、科研吞吐和防蒸馏,数字都是自己测的
GPT-6.2 Astra 与 Sol 的正式发布在 11 月 18 日 01:45(Asia/Singapore),早于本期窗口,定价与系统卡已在上期写过,这里不再重写。本窗口真正新的,是 OpenAI 连续用官方博文,把“模型变强”从聊天产品扩到芯片设计、内部科研节奏、蒸馏防护和药物化学基准。这些关键百分比都来自 OpenAI 自己的测量,必须标明官方自报,尤其不能写成外部审计或野外验证。
芯片设计方面,@OpenAI 在 11 月 19 日 01:05 指向博文用模型推进芯片设计。官方称与 AMD 合作,在 AMD 工程师已多年优化的旗舰 GPU IP 上,模型找出最多 14% 的 PPA(功耗、性能与面积)改进,用时不到五个月;其中部分改动已被 AMD 送去制造,另一些进入未来版本的生产设计文件。同一方法用于 OpenAI 自研推理芯片 Jalapeño:官方称向量单元标准单元面积约降 13%、矩阵单元约降 10%,并已在硅验证中得到确认。博文还提到与 Synopsys 合作训练 GPT-Synopsys,以及在开源 RISC-V 核心上的对比评测。“最多 14%”是相对已高度优化基线的口径,而且含有 AMD 验证的表述,不宜改写成无条件的工艺突破。
研究加速报告把镜头对准 OpenAI 自己的实验室。研究加速:参差的前沿 的 News RSS 时间为 11 月 18 日 16:00(Asia/Singapore),@OpenAI 在 11 月 19 日 07:07 转发。官方自报:2026 年 3 月至 10 月,对“估计需要人做 2–4 小时”的任务,零干预成功率从 23% 升到 46%;4–8 小时任务从 13% 升到 35%。按任务类型,监控训练运行为 79%,启动训练运行为 35%,编写推理与 serving 代码为 25%。按 API 标价,10 月研究者每日用量中位数约 $2,400(比 9 月高 62%),90 分位约 $23,000(高 105%);9 月基线是 $1,500 / $11,000。问卷里,为保留三个月的前沿编码智能体,中位数愿意拿团队算力的 30%,或另题中的团队编制 40%。Safety & Alignment 的记录工作周在 1–9 月增加 77%,是各研究方向里绝对增量最大的。每个研究者的“智能体工作日”(每 8 小时计 1 日)从 0.5 增到 5.7(约 11 倍);预训练与后训练团队约 8,扩缩与基础设施约 4。到 10 月中,超过三分之二的纳入统计研究者日峰值至少 4 个并发智能体,超过 10% 至少 16 个。9 月,研究组织里智能体使用的 API 等价花费约为非股权薪酬的两倍(股权通常占目标薪酬 70%–80%,未计入);内部部署只占研究算力的 2%。文中明确:这是对递归自我改进(RSI,即系统用自身输出来改进自身)指标的透明报告,不应读成追求完全递归自我改进的声明,人仍在回路里。方法学会随能力变化而修订,这些内部使用数字也不能外推到其他实验室或对外 API。
安全方法文对抗蒸馏在 11 月 21 日 03:33 由 @OpenAI 发布。蒸馏在这里被写成安全问题:能力可能被转移到防护更弱的模型。官方称,在内部自适应红队评估中,从先前一轮回复提取受保护推理的平均攻击成功率,从 GPT-6 Astra 原防护下的 54.0% 降到 GPT-6.2 Astra 更新防护下的 0.2%;针对当前请求的数字是 22.9% 降到 0.9%。这是官方内部评估,不是外部复现,本稿只记结论,不转写提取或攻击步骤。
同一天稍后,@OpenAI 介绍新基准 MedChemBench,RSS 时间为 11 月 20 日 08:00。它用 99 道来自已发表研究的药物化学推理题,源自 117 篇论文与专利,含 761 个不同分子结构,四部分是结构复原、科学解释、排序/选择、数值性质预测。官方称在 xhigh 推理档,GPT-6.2 Astra 得到可用分数的 84.5%,对照 GPT-6 Astra 83.3%、GPT-6.1 Sol 82.0%、GPT-5.6 Sol 58.2%。官方自己写明:这不能证明模型能发现新药或改进实验室决策,也不能排除对已发表材料的先验接触;每次作答是单次尝试,不用工具、没有反馈、也没有新实验。发布文给出了论文 PDF,本刊数字取自发布文,未逐表深读 27 页正文。
关心半导体与自定义芯片的人读芯片博文,并保留“最多 14%、相对已优化基线”的限定。关心科研自动化与治理的人,应把这份内部吞吐报告,和上期 GPT-6.2 系统卡里“AI 自我改进”的高风险阈值对照着看,但不要把内部使用数字读成对外模型能力。安全与政策读者看蒸馏文的评估设定;药物化学读者必须连同官方的限度声明一起引用 MedChemBench。
深入学习建议
- 芯片与内部验证先读芯片设计博文,注意“最多 14% PPA”的基线和 AMD 验证表述。
- 科研治理读研究加速报告的任务分档,以及“人仍在环内”的声明。
- 安全与药物化学分别读对抗蒸馏和 MedChemBench 发布文,不要把内部红队成功率或历史题集分数写成已在野外或实验室得到验证。
主线:长程 agent 的记忆该压短还是原样存,安全审计却几乎分不清被破坏的记录
本窗口的学术侧,最值得并排放在一起的,不是又一份“某模型分数更高”的报告,而是三件彼此对照的事:压缩工作上下文会不会把还没做完的活做砸;干脆不压缩、需要时再搜索,能不能成为可训练的基线;以及当模型可能破坏用于改进自身安全的研究时,人能不能从完整记录里把破坏找出来。这和上一主线里 OpenAI 的研究加速报告是同一主题的另一面:智能体越深地进入研发,记忆、压缩和审计是不是跟得上。
CompAct-Bench(2611.25673) 来自复旦大学、腾讯混元与清华深圳国际研究生院,不要写成单一机构论文。长程智能体常把历史交给一个模型压短再继续干;这篇把压缩器与执行器拆开,看压完之后还能不能把活做完。作者自报:200 项过程级任务,覆盖信息检索、软件工程与办公自动化,评估 12 个前沿模型作压缩器。入选任务在压缩前三次预筛中全部做成,压缩后平均准确率降到 56.7%,最好的模型也只有 68.5%(摘要未点名该模型,本稿不补)。失败路径被概括为两类:漏掉信息导致重复劳动、预算耗尽;以及状态被写歪,把尚不确定的证据写成结论并过早结束。这些是该套件、该执行器协议上的数字,不能外推到其他压缩实现。
GrepMem(2611.25123) 来自南加州大学,走了相反的路:不先决定“该记什么”,而是把完整历史追加成纯文本日志,用正则搜索按需召回。它和上期的 HEAMS、以及本期 CompAct-Bench 正好形成对照——有人做结构化记忆与治理,有人把压缩本身当能力,这篇则把“无损、无索引”做成一种可训练的基线。作者自报,在五种上下文管理策略下用强化学习训练 Qwen3.5-9B(这是被训练和评测的底座,不是作者单位),ContextBench 准确率 95–97%,有损基线最高 21%;在 BCP-Multi 上比 SUPO 的摘要法高 8.8 个百分点,并称在五个任务上都还留在准确率与 token 成本的 Pareto 前沿。这是该模型、这五套任务上的结果,不能直接说“grep 已经替代结构化记忆”。
安全评测则提醒:单看指令或单屏往往不够。SEAM(2611.22971) 由清华大学、香港中文大学、ByteDance 与深圳大学合作,不要写成单一的清华或 ByteDance 论文。它要测的是:每条指令、每一屏单独看都无害,组合起来才有害时,智能体还会不会做下去。作者自报,在 600 项跨应用、多步的 OSWorld 任务上,开源权重与旗舰智能体在最多 92% 的运行里仍会执行该组合危害,但若用户用一句话直接说出同一危害,则会拒绝。智能体常常已经打开了关键页面,暴露本身不是主要瓶颈;问及时能标出危害,思维链里有时也会写下冲突,然后仍然确认执行。作者称专有模型明显更谨慎。识别危害并不稳定地转化成安全执行,而且更取决于信息是出现在用户指令里,还是出现在屏幕上。本稿只记结论,不写任务构造。
2611.21832 把问题推得更远。作者来自 Redwood Research、佐治亚理工学院、独立研究者与 Equistamp。设定是:模型可能破坏用于改进自身安全的研究;研究者用人类专家做代理破坏者,再让审计人员看完整记录并复跑实验。作者自报:10 项新的安全研究实验,得到 10 条良性与 12 条被破坏的记录。人类审计人员在能看完整记录并复跑实验的条件下,区分两者的 AUROC 为 0.59,与随机无显著差异;只有 17% 的案例完全找出具体破坏。摘要还写,在不允许复跑实验的条件下,前沿模型可能高于人类审计(Fable 5.1:AUROC 0.73,完全识别 32%)——这两条不是同一协议,不能合成“模型已经比人会审计”。这是小样本、人工代理破坏的压力测试,不是对线上系统已被破坏的判断,本稿也不转写破坏手法。
日常做上下文压缩、handoff 或记忆折叠的人,应先看 CompAct-Bench 的失败路径;想把“先记下来再搜索”做成基线的人看 GrepMem;做计算机使用安全或内部安全研究审计的人,分别读 SEAM 与 2611.21832 的协议限制。四篇的数字来自完全不同的实验,不能放在一起比。
深入学习建议
- 做上下文压缩的读者先读 CompAct-Bench(2611.25673) 的任务协议和两类失败路径。
- 想对比“无损日志 + 搜索”路线的读者读 GrepMem(2611.25123),并对照上期 HEAMS。
- 安全与审计读者读 SEAM(2611.22971) 和 2611.21832,只取结论与协议,不把小样本压力测试写成线上事故。
X 动态
主线:Anthropic 定价 $83 并完成首两日交易,但 $813.4 亿是发行规模,不是市值
上期写到 11 月 17 日的 S-1/A 与 8-A12B 时,发行价仍是 $70–78 的待定区间,采集时尚未定价、尚未开盘。本窗口有公司新闻稿、@AnthropicAI 主帖和最终招股书 424B4,可以把发行条款写成已披露事实;首两日行情则用 Nasdaq 新闻室与主流行情源交叉。先把最容易写错的地方说清楚:424B4 封面价目表里的公开发行总价约 $813.4 亿,是发行规模,不是市值;媒体给出的市值数字一律标待核;采集时 SEC 公司页未见交割 8-K,本稿不把交割写成已核事实。本篇也不做任何投资判断。
定价以公司新闻稿和 424B4 索引为准。Anthropic, PBC 将 IPO 定价为每股 $83.00,发行 980,000,000 股 Class A 普通股,其中公司出售 956,351,354 股,出售股东出售 23,648,646 股;公司不会从出售股东的股票中获得任何所得。承销商有 30 天期权,可再向公司购买最多 147,000,000 股。公开发行总价 $81,340,000,000,也就是 9.80 亿股乘以 $83;承销折扣合计 $550,000,000;扣除承销折扣后、费用前,公司所得 $78,840,438,875,出售股东所得 $1,949,565,525。注册声明已于 11 月 18 日被 SEC 宣布生效。股票预计 11 月 19 日起在 Nasdaq Global Select Market 以代号 ANT 交易;招股书写明发行预计 11 月 20 日交割,须满足惯例交割条件。@AnthropicAI 在 11 月 19 日 07:29(Asia/Singapore)确认“定价 $83,预计明天开始在 Nasdaq 交易”。424B4 于 11 月 19 日提交,Accepted 时间为美东 11 月 19 日 06:05:50,约合 11 月 19 日 19:05(Asia/Singapore),登录号 0001628280-26-074944。截至采集时,SEC 公司页(CIK 0002130357)可见 424B4、S-1MEF、CERT、S-8 与 11 月 19 日的 FWP,未见交割 8-K。Anthropic 另有一篇日期为 11 月 20 日的发行完成公告页,本稿仍以未见 8-K 为准,不把交割写成已核事实。
同期还有一笔写在 424B4 里、有条件的 Class N 私募:发行完成后、在满足若干条件的前提下,Google、NVIDIA、AMD、Broadcom、Micron、Microsoft 与 TSMC Partners 将按每股 $83 向公司购买合计 $26.0 billion、共 313,253,007 股 Class N。其中 Google 与 NVIDIA 各约 $10.0B(各 120,481,927 股),AMD 约 $2.5B(30,120,481 股),Broadcom、Micron 与 Microsoft 各约 $1.0B(各 12,048,192 股),TSMC 约 $500 million(6,024,096 股)。私募所得全部归公司,不付承销折扣。招股书估计 IPO 与该私募合计净所得约 $104.8B,若绿鞋全部行使则约 $117.0B。这不是二级市场成交,交割仍取决于发行完成等条件,不能和公开发行总价、更不能和市值混写成一笔“已到账募资”。
首日交易对应美东 11 月 19 日,开盘约 11 月 19 日 22:30(Asia/Singapore)。Nasdaq 新闻室写明开盘 $111.50。Yahoo Finance 历史行情为:开 $111.50、高 $115.10、低 $92.72、收 $97.17,成交量 857,312,300。相对发行价 $83,开盘约 +34.3%,收盘约 +17%。CNBC 与 Reuters 报道同样给出开盘 $111.50、收盘 $97.17;不同行情源的成交量略有出入,CNBC 写逾 8.46 亿股,本稿成交量以 Yahoo 历史表为准。次日交易对应美东 11 月 20 日,常规收盘约 11 月 21 日 05:00(Asia/Singapore)。Yahoo Finance:开 $89.86、高 $92.56、低 $83.05、收 $88.91,成交量 399,629,474;相对首日收盘约 -8.50%,相对发行价仍约 +7.1%。Reuters 亦报道周五收于 $88.91。采集时已是周六上午,美股无常规交易;Yahoo 显示 11 月 20 日盘后约 19:49 ET(约 11 月 21 日 08:49,Asia/Singapore)为 $88.69,只是盘后快照,不是正式收盘价。
市值叙事必须单独标待核。媒体与公开摘要里出现过定价时约 $1.5T、盘中一度约 $2T、首日收盘完全稀释约 $1.8T,以及约 $1.28T 等说法,分母与口径不一致。在公司未给出可核对的完全稀释股本、且未见交易所官方市值公告之前,这些数字一律待核,本稿也不自行换算市值。此前还有把募资规模写成约 $107.3B 的说法,与 424B4 的 $81.34B 公开发行总价不符,不能当作已核事实。
写发行条款只引用公司新闻稿和 424B4 价目表;写开盘价优先引用 Nasdaq 新闻室;写高低收与成交量用 Yahoo 等主流行情表,并注明来源。不要把预测市场或转述摘要里的估值、募资总额直接写进正文当事实。若后续出现交割 8-K 或绿鞋行使公告,应另核净所得。
深入学习建议
- 发行条款先对公司定价新闻稿和 424B4 索引的封面价目表,把发行规模和市值分开抄。
- 开盘价看 Nasdaq 新闻室,高低收与成交量核 Yahoo Finance 历史行情。
- 持续跟踪交割与绿鞋时,以 SEC 公司页是否出现 8-K 或后续文件为准。
主线:Genie 4 从订阅产品走进 API,Tool Retrieval 则专治工具一多就把上下文撑爆
同一窗口里,Google 先把 Genie 4 作为可玩的世界模型交给 Ultra 订阅用户,次日再把同一模型放到开发者 API,并单独发布面向大规模工具库的 Tool Retrieval。这是产品和平台两步,不要写成“只发了一个演示”。
@GoogleDeepMind 在 11 月 19 日 02:14(Asia/Singapore)宣布 Genie 4 在 Project Genie 中上线,带原生音频、实时编辑,以及协助创建可交互世界的新 agent,面向符合条件的 Google AI Ultra 订阅用户;Pro 可在同一页面候补。需要注意:DeepMind 研究概述页Genie 4: A new generation of world simulation 的 RSS 时间为 2026 年 10 月 27 日,早于本窗,不是本期新论文宣布。本窗口新的是产品开放和接口。
次日,@GoogleAIStudio 在 02:10 宣布 Genie 4 进入 Gemini API。changelog 写明模型代码为 genie-4,在 Interactions API(v1beta)正式提供:从文本、16:9 参考图或两者生成,实时 720p / 24 fps、同步 48 kHz 立体声,经 WebRTC 或 WebSockets 传输。付费层定价为每百万 token $1.50 输入 / $9.00 文本输出 / $17.50 视频输出(官方约合每秒 $0.10,立体声包含在视频输出里)。单次会话最长 120 秒;官方称视觉连贯与物体持久在前 45–90 秒最强。模型文档写明该模型不支持 function calling 与 Tool Retrieval。
Tool Retrieval 是另一件事。@googledevs 在 11 月 20 日 03:06 宣布这项 Interactions API 预览功能。做法是加入 tool_search,并对暂不需要的工具设 defer_loading: true,让模型先看到名称与描述,需要时再加载完整参数 schema。官方称适用于 Gemini 3.6 及之后模型(含 Gemini 4),也可用于远端 MCP(Model Context Protocol,一种让模型按需调用外部工具的协议);无单独加价,仍按所用模型的输入/输出计费。Genie 4 本身不在此功能范围内。相邻产品上,@GeminiApp 称 Gemini 应用的 Mac 版已支持 computer use,可在用户不交出屏幕与光标的前提下,于后台窗口点击、滚动和输入,并把任务交到本地文件夹、应用和网页。
想“玩世界”的人读 Project Genie 博文和 Ultra / Pro 资格;要接入实时世界流的开发者读 Genie 4 模型页与价目,注意会话时长和不支持函数调用;工具很多、schema 容易把上下文和缓存前缀撑爆的 agent 开发者,读 Tool Retrieval 博文,不要误以为 Genie 4 也能用该功能。
深入学习建议
- 产品资格先看 Project Genie 更新文。
- 接入实时世界流读 Genie 4 API 博文和模型文档的会话上限与不支持项。
- 工具很多的 agent 开发者读 Tool Retrieval 博文,确认适用模型列表。
主线:GPT-Live-1.1 和 background 模式把“能用”改成“可等、可省”,目录标识不是权重
GPT-6.2 本身已在上期主条写过。本窗口开发者侧的新事实,是语音 API 迭代、可等待任务的折扣、推理缓存方式的变化,以及 OpenAI 用 Codex agent 维护 ChatGPT 性能的内部系统被写成公开博文。GitHub 上的 SDK 与 Codex 发行说明会同时出现 gpt-live-1.1、GPT-6.2 Sol 与 Astra 这些名字,必须先记住:它们是 API / 客户端目录里的标识,不是权重发布。
@OpenAIDevs 在 11 月 20 日 04:00(Asia/Singapore)宣布 GPT-Live-1.1 已在 API 可用,称跨语言口音更自然、更稳定,并新增 standby 以降低空闲成本。开发者文档写明模型 ID 为 gpt-live-1.1,经 v1/live/sessions 提供全双工语音;按时长计费,活跃 $0.05/分钟、standby $0.02/分钟,后端模型与工具另计。同一窗口,OpenAI Python SDK 从 v3.55.0 升到 v3.57.0,Node SDK 从 v7.60.0 升到 v7.62.0:先加入 Live 的 MCP 服务器配置,再把 gpt-live-1.1 写入 Live 模型选项,并支持 Live WebRTC standby。这些同样只是目录与客户端能力,不是新的开源权重。
对可以等待的任务,折扣更直接。@OpenAIDevs 在 11 月 19 日 06:54 称,在 Responses API 的 background mode 为 GPT-6.2 Astra 或 Sol 选择 2 小时或 8 小时的“首次响应”目标,可比 Standard 每 token 最多节省 40%。这是官方自报的条款口径,不是第三方复测。11 月 20 日 07:56,官方又说明从最新旗舰模型开始,Responses API 里每条推理项会绑定到此前的对话历史,agent 可在此基础上继续,以更少 token、更多缓存命中得到更好结果;编辑更早的消息会打破这一绑定。主帖在此处有截断,细节以官方后续文档为准,本稿不补写未见原文。
Performance Factory 则把内部值班方法公开了。@OpenAIDevs 称,该系统调度 Codex agent 调查性能回退、提出供工程师审阅的修复,并在上线后检查是否恢复基线。官方称回归工作流在三个多月里跟踪了超过 1,700 次调查,其中逾 600 次定位到根因,约合每天 17 次自动调查。数字是官方自报,不要写成第三方审计。
做语音会话的人读 GPT-Live 文档和价目,把 standby 和后端模型费用算进总成本。做长任务、可以异步等结果的人,看 background mode 的 2 小时与 8 小时目标,并记住“最多省 40%”是官方自报。关心推理缓存的人注意:改历史消息会断开绑定。SDK 升级到 3.57 / 7.62 可以接上这些接口,但不等于某个新模型的权重已经开放。
深入学习建议
- 语音会话先读 GPT-Live-1.1 文档的活跃 / standby 价目。
- 可等待任务对照 @OpenAIDevs 关于 background mode 的说明,在预发环境比较 Standard 与 2 小时、8 小时目标。
- 升级客户端时看 Python v3.57.0 与 Node v7.62.0 的发行说明,不要把目录标识当成权重发布。
热门开源项目
主线:ComfyUI 0.46.0 接上新模型工作流,也砍掉了 DirectML
本地图像与视频工作流这边,本窗口最值得升级的正式版是 ComfyUI v0.46.0,由 Comfy-Org/ComfyUI(原 comfyanonymous/ComfyUI)在 11 月 19 日 06:55(Asia/Singapore)发布,prerelease=false。核心侧新接入 PAN2 与 SenseNova 的思考、交错生成和自纠错,并增加 Video Deflicker 节点和更快的 RAFT 光流;工作流上可把多段视频对齐到第一段的帧率和音轨,还支持拆分图像通道、保存单通道 PNG。合作节点里补了 MiniMax H3 Image,以及一批云端模型目录标识——不要把这些目录名写成新的开源权重。
这一版也有明确的不兼容:去掉了 DirectML 支持,并在支持 CUDA 13 的 GPU 上提示不要继续用旧 CUDA。做本地图生视频、还在用 DirectML,或要跟 PAN2 / SenseNova 工作流的人应该升,但升之前先确认运行时不再依赖 DirectML,并按提示核对自己的 CUDA 版本。同窗口还出现了 Comfy-Org 给美团 LongCat-Video-Avatar 做的打包分发,属于工作流分发版,不是新的基础模型。本窗口 vLLM、SGLang、llama.cpp 等推理基础设施没有新的正式版,所以本地创作工作流这边,真正会改默认行为的升级主要就落在 ComfyUI。不升也可以继续跑旧工作流,但新的思考/交错生成节点、视频去闪与多段对齐,都只在 0.46.0 之后才齐。
深入学习建议
- 先读 v0.46.0 Release 里 DirectML 移除和 CUDA 13 的提示。
- 再用一条现有工作流在预发环境跑通 PAN2 / SenseNova 或视频对齐节点,确认输出帧率与音轨符合预期。
- 看到云端模型目录名时,回到对应官方组织核对是否真有开放权重,不要把目录标识当成可下载的新模型。
主线:Codex 把工作区设成默认,终端开始能打电话,目录里的新名字仍不是权重
openai/codex 在窗口内连续发布两个正式版:0.170.0 于 11 月 18 日 11:40(Asia/Singapore),0.171.0 于 11 月 20 日 08:44,均为正式版;同窗口多枚 *-alpha.* 未收入本条。0.170 给终端补上实时语音通话的 WebRTC 协商,并修了 Cloud 会话重连和 Windows 沙箱权限。0.171 把上期还是可选的终端工作区改成默认打开,可在主对话旁预览文档、图片和子智能体记录;并增加 codex exec --remote,以及用 /rc、/remote 管理本机远程控制与设备配对。
模型目录里加入了 GPT-6.2 Sol 与 Astra,并把 Sol 设为默认目录选项。这与同期 Python / Node SDK 写入 gpt-live-1.1 是同一类事情:客户端目录标识,不是新的权重发布。日常用 Codex 终端、或要在已有 app server 上跑非交互任务的人,应该升到 0.171;需要实时语音协商或 Windows 沙箱修复的人,至少不要停在 0.170 之前。默认打开工作区,意味着预览文档、图片和子智能体记录会成为日常界面的一部分,适合长时间驻留在同一个仓库里干活的人;如果团队对“终端旁边自动打开预览”更敏感,升级后先检查权限与展示范围。远程执行和设备配对是可选项,先在受控环境里试验 /rc、/remote 和 codex exec --remote,不要一上来就接到生产机器。
深入学习建议
- 先读 0.171.0 Release,确认默认工作区、远程执行和目录默认模型。
- 需要语音通话或 Windows 沙箱修复的人再看 0.170.0 Release 的修复范围。
- 把 Codex 目录里的 GPT-6.2 名称,和上期已经核对过的官方 API 定价对照,不要写成“GitHub 上发布了新权重”。
主线:Unsloth 接到 AMD NPU 和 Inkling 2 Mini,热榜上的假仓不要当项目下载
unslothai/unsloth 在窗口内连续发布 v0.1.920-beta、v0.1.921-beta 和 v0.1.922-beta。标签仍带 -beta,但 API 字段均为正式发布。920 把自行转换的 Q4NX 文本模型接到 AMD NPU,并开放 LTX-2.5、MOSS-Image 的 LoRA 训练,以及 Cosmos3 的 FP8 视频权重;配套有 AMD 官方博客。921 与 922 接入 Inkling 2 Mini。发布说明写明约 26B 总参数、5.4B 激活、1M 上下文,自称“同体积最强”、可在 16GB 内存上跑——这些是 Unsloth 自称。Thinking Machines 的官方口径是总参数 26.4B、激活 3.4B,计循环后每 token 权重激活约 5.4B,检查点约 20GB,并写明 32GB 内存的 Apple 芯片设备或单卡 32GB 显存即可运行。两边不要混写成同一句。Unsloth 还称,8GB 显卡上 MiniMax-H3-Image 新提示从 82.7 秒降到 36.7 秒,GGUF 图像模型加载内存少 52–66%,MCP 对话少处理 83–87% 提示词,均为自称。有 Ryzen AI 机器、想训视频或图像 LoRA,或要在桌面端跑 Inkling 2 Mini 的人可以跟上,但部署内存应以官方模型卡为准,性能数字保持“自称”。
这一条还要同时写安全提醒,所以正文不给任何可疑仓库的链接。热榜口径是:日榜约为最近 24 小时,周榜统计最近七天,均于 2026 年 11 月 21 日 08:50(Asia/Singapore)抓取,不可当作本期 72 小时净增。港大数据科学组织的 CLI-Anything 出现在日榜前列,官网可核,但最近正式版仍是 6 月的 v0.4.0,本期不单列;周榜前列也多为旧仓留榜。新仓搜索前列则混有大量可疑项目,未作为项目收录:有的是两天内新建、账户名随机、README 关键词堆砌且仓库语言为空的所谓插件仓;有的是非官方的应用商店结算试用脚本;另有锁屏绕过、安装包克隆,以及一批星数相近的“战术 HUD”仓。继续看不到可交叉核验进展的超长上下文仓,也仍不收录。缓解办法很直接:不要运行来路不明的“试用”“解锁”或“官方插件”脚本;下载模型与插件只认官方组织;已经误跑过脚本的人,应更换相关密码与 API 密钥,并检查本机权限。
窗口内 vLLM、SGLang、llama.cpp(仅预发布日构建)、Ollama、transformers、PyTorch 等基础设施没有进入本条的正式版更新。Anthropic 与 LangChain 的 SDK 多为管理接口或补丁,也不单列。
深入学习建议
- 桌面端与 NPU 用户先读 v0.1.922-beta、v0.1.920-beta 和 AMD 博客。
- 跑 Inkling 2 Mini 时以 官方说明 对照 Thinking Machines 模型卡的内存与激活参数口径。
- 看到“官方插件”“试用工具”或借用新模型名字的新仓,先核组织认证与许可证,不要运行脚本。
模型相关
主线:腾讯 Hy4 把旗舰权重放出来了,但许可从 Apache-2.0 收成了大型 MaaS 要另签的条款
本窗口分量最重的开放权重,是腾讯混元把旗舰 Hy4 和轻量版 Hy4 flash 一起放到 Hugging Face,各配 FP8 量化版和预训练 base 版,共 6 个仓库,并有 GitHub 上的 Hy4 与 Hy4-flash 页面。往期 11 月 6 日核验时,HF 上还没有 tencent/Hy4 仓库,它当时只在 Artificial Analysis 上以闭源身份出现。Hy4 是 770B 总参、49B 激活的 MoE(78 层,256 路由专家取 top-8,带 Gated DSA 稀疏注意力与 IndexCache,1M 上下文),支持文本、图像和视频理解;Hy4 flash 是 220B 总参(含 64B 的 n-gram “Engram” 参数)、12B 激活,混合稀疏/滑窗注意力和 LatentMoE(512 专家取 16),定位“最省钱的 Hy 模型”。两者都内置 DFly2 草稿模型做投机解码。权重体积也把门槛写得很清楚:Hy4 的 BF16 约 1.55TB、FP8 约 786GB,需要多机;Hy4 flash 的 BF16 约 441GB、FP8 约 287GB,门槛低得多。采集时(11 月 21 日 09:00,Asia/Singapore)Hy4-flash 为 Trending 第 8,likes 545、下载 3,949;Hy4 为 Trending 第 21,likes 127、下载 89。窗口内还能搜到大量 GGUF、MLX 等衍生仓库,腾讯压缩工具组织 AngelSlim 的官方 GGUF 版下载已到 75,614。
要先讲清楚的是许可。8 月的 Hy4-preview 是 Apache-2.0,这次正式版 6 个仓库都改成了自定义的 Tencent Hy License 1.0,HF 元数据为 other(tencent-hy-license)。LICENSE 全文开头写明它衍生自 Apache License 2.0,但“This License is not the Apache License”。第 10 节规定:经营 MaaS(对外提供推理或微调 API)业务,且全球年营收超过 5,000 万美元,或用于月活超过 1 亿的产品时,须另行取得腾讯书面授权;纯内部使用(模型和输出都不对外)不受此限。Hy4 与 Hy4 flash 的 LICENSE 逐字节相同。结论是:这是开放权重,自定义许可,不是 OSI 开源。做云服务或 API 转售的公司要先判断自己是否落在门槛内;内部自用不受此条约束。
Artificial Analysis 随即把 Hy4 从闭源改标为开放权重(commercial-license),分数仍是 34.6,成为开放权重第 2,排在 Kimi K3.1 Pro 的 46.5 之后、DeepSeek V4.1 Flash 1017 的 32.6 之前。Hy4 的 AA 发布日期仍写 2026-11-03。Hy4 flash 本次没有确认到 AA 单页分数,是否已有 AA 分、以及具体公开了哪些评测,待核。卡片上的分数都是腾讯自测,例如 Hy4 flash 在内部基准 WorkIndex 上 42.1(Hy4 preview 为 39.7)、单任务成本是 Hy4 preview 的 1/13,盲测满意度 2.79/4(对照 Claude Haiku 5.5 的 2.81/4),解码速度“超过 150 tokens/s”;KV cache “是 Hy3 的 1/24、Hy4 的 1/6”,均为卡片自述。Hy4 的确切公开时刻也待核:仓库创建于 10 月 29 日,但历史被压成单个 commit,上期扫描时尚未公开。
想自托管国产大模型的团队,Hy4 flash 的体积更现实,卡片给了 vLLM / SGLang 部署和 DFly2 配置。普通读者记住三句话即可:Hy4 是腾讯旗舰开放权重,Hy4 flash 是更好部署的版本,许可证可商用,但对大型 API 厂商设了门槛。不要把“开放权重”写成“开源”。
深入学习建议
- 先读 tencent/Hy4 和 tencent/Hy4-flash 的模型卡规格,再打开 LICENSE 第 10 节。
- 对照 AA 模型榜 里 Hy4 的开放权重标记与 34.6 分,不要把尚未确认的 Hy4 flash 分数补进去。
- 部署前按 BF16 / FP8 体积估算机器,并核对其是否属于需要另签授权的 MaaS 场景。
主线:Inkling 2 Mini 用循环层换体积,Apache-2.0,32GB 内存就能跑
Thinking Machines 在 Inkling 2 Small 之后,于 11 月 20 日放出更小的 Inkling 2 Mini。发布文页面元数据为 11 月 20 日 08:00(Asia/Singapore),也可能只是日级占位,精确时刻待核;卡片写明发布日期为 November 20, 2026,权重提交在 11 月 21 日 06:02。它是本窗 Trending 上排名最高的新模型(第 4),许可 Apache-2.0,是开放权重且属于 OSI 许可;另附使用政策,但不改变许可证类型。
结构按官方自报:MoE,总参数 26.4B、激活 3.4B;24 层里中间 12 层(两个 6 层块)共享权重、每个 token 默认循环 3 次,于是每 token 有 48 次层计算,官方折算“有效激活约 5.4B”。多数权重以 NVFP4 训练和部署,最后四层 MXFP8,单个检查点约 20GB(主权重约 19.5GB,另有 MTP 草稿文件),官方写明 32GB 内存的 Apple 芯片设备或单卡 32GB 显存即可运行,上下文 1M,支持文本与图像输入。训练过程也写进了博客:先以 384 选 8 专家训练,中途按使用率剪掉三分之二专家只留 128 个,再用一个更大的内部 Inkling 模型蒸馏 1T token“愈合”,之后 SFT 加 2.2T token 的强化学习。同时放出的研究版 TML-d24-varloop-research 是同架构、可在推理时选择循环 1–5 次的变体,专供研究“多循环一次到底带来什么”,不提供 API。两个仓库的权重文件大小相同,但哈希不同,是另一套权重。
评测要分官方自报和第三方。官方主比较口径是“总参数小于 100B 的开源权重模型”,并称在该口径下,DeepSWE v1.1(mini-swe-agent v2.4.6)48.2%、Vals Index v2.2 46.5%,领先所有对照;SWE-bench Pro v2 Hard(51 题,同一 harness)77.9%。同表还给出 FrontierCode v2.0 15.1%、Terminal Bench v2.1(pi v0.83.0)71.6%(该行 Qwen3.8-27B 为 73.0%,Mini 是第二)、SWE-bench Verified(仅 bash)79.2%、BrowseComp(带 compaction)79.0%、MCP Atlas Public 82.7% 等,均须带上表内 harness。表内也列了总参数 124.5B 的 Nemotron 3.5 Super VL,它不在“小于 100B”这句里,不能混用。官方自己写明短板:多轮对话和多约束指令(MultiChallenge 50.0%、ComplexConstraints v1.1 33.4%)不如 Qwen3.8-27B。可变循环实验称,无思维链时程从 1 次循环的 16 秒提到 3 次的 37 秒;串行推理基准在训练所用循环数的两倍(10 次)上仍在提升;思维链随循环变短但仍可读;循环加多后,agent 破坏类测试没有变高的趋势。知识类基准不随循环提升,模型靠搜索和工具补事实。除 AA Index 外,上述分数均为自测。第三方方面,AA Intelligence Index v5 给它 20.1 分(页面为 20.13),与 Qwen3.8 27B 打平,在 4B–40B 开放权重组里排第 2/16;AA 页面写“26B parameters (5.4B active)”,输出速度 280 tok/s,价格输入 $0.15 / 输出 $0.50(每百万 token,提供方为 Thinking Machines 自家 API)。它不在 AA 首页默认 28 个模型里。
想在笔记本或单卡上跑 agent、编程助手的开发者,可以优先拿它和 Qwen3.8-27B 对比;研究循环模型与思维链可监控性的人,读发布文里 Monitorability 一节,再用可变循环研究模型复现 1–5 次循环的对比。上期的 Inkling 2 Small 在本窗口又做了一次影响使用的修补:官方补上了 eos / pad、给 chat template 加上 assistant 的 generation 标记,并新增 generation_config.json,权重文件未变。自己做微调或批量推理的用户应同步最新配置;Mini 首发就已经带上这套配置。
深入学习建议
- 先读发布文和 HF 模型卡,分清 3.4B 激活与计循环后的 5.4B。
- 研究循环次数的读者打开 TML-d24-varloop-research 与可变循环模型卡。
- 引用第三方分数时用 AA 的 Mini 模型页,并与官方小于 100B 口径的自测表分开写。
主线:微软用 MIT 预告 Windows 内置小模型,DaisyRose 则表明纯 RL 也能推动 27B
开放权重的另一头,是两个体量更小、故事却很清楚的发布:一个是即将进入操作系统的端侧底座,一个是在现成 27B 上只做强化学习的公开样本。许可都比许多自定义条款更利落——前者是 MIT,后者是 Apache-2.0。
Aion 1.0 Instruct 2.3B 来自微软 Windows 应用科学组,权重约 4.58GB,HF 解析参数 2,288,831,488,许可 MIT。卡片定位很直接:它是 Windows 生态的基础小模型,主打本机上的摘要、改写、问答和操作系统场景,32K 上下文,支持英、德、西、葡、意、法、中、日 8 种语言;进一步优化、并搭配微软内容审核模型的版本,会在 2027 年 1 月底成为 Windows 系统内置的小语言模型。HF 版是“提前公开、收集反馈”,先放未量化版,量化版之后再出。另有 ONNX-WebGPU 版 面向浏览器内推理,示例代码在 GitHub。卡片没有给出基准分数,也没有技术报告;“2027 年 1 月底成为 Windows 内置模型”是卡片表述,以微软正式公告为准。LMArena 与 AA 都未收录。做 Windows 应用、本地 RAG 或隐私敏感场景的开发者,可以先下载评测和微调。
DaisyRose-27B 是 RadixArk(SGLang、Miles 训练框架背后的团队)的第一个模型。它不是新基座,而是在 Qwen3.8-27B 上只做强化学习、不做 SFT 和蒸馏:约 1,200 个精选长程 agent 任务、单会话最长 1M token,在 144 张 H200 上训练 18 天。架构、分词器和 chat template 都和 Qwen3.8-27B 一样,可以直接替换;权重 55.56GB,解析参数与基座完全相同。许可 Apache-2.0,基座本身也是 Apache-2.0,许可链无冲突。官方自报的主要提升是 Terminal-Bench 4.1 pass@1 从 5.6 升到 12.0,其他基准多为小幅提升,例如 Terminal-Bench 2.1 73.0 升到 75.5、GPQA Diamond 89.2 升到 90.7;卡片上的 SWE-bench Pro v2 94.7、IFBench 82.4 等同样是 RadixArk 自测,Terminal-Bench 4.1 还绑定了其内部 mini-swe-agent 框架。AA 与 LMArena 未收录。官方博客把任务设计和基础设施写得很完整,训练框架 Miles 也开源。已在用 Qwen3.8-27B 做 agent 或编程的人,可以直接替换对比。
同一底座上,上期写过的 LoRA harness-hub/Qwen3.8-27B-pi-adapted 本窗口成了 HF Trending 第 2,但作者在 11 月 19 日更正了关键数字:基座 Qwen3.8-27B 开 xhigh 思考时,SWE-bench Pro(hard 51 题)从 64.7% 更正为 74.5%;adapter 不开思考仍是 64.7%。卡片表述随之改成:在 SWE-bench Pro 上拿到思考档 35 个点提升中的 25 个(64.7% 对 74.5%),生成 token 约少 4.5 倍;Terminal-Bench 2.1 上仍与最高思考档持平(56.6% 对 54.2%),SWE-bench Pro 上落后约 10 个点。全部是作者自测,样本只有 51 题。引用上期“不开思考就追平最高思考档”的说法时,必须改用更正后的数字。
榜单只能写看到的那一段,详细名次见次要动态。这里只需记住两件事:AA 已把 Neon 记为 61.4、默认视图第 3,并把 Hy4 改标为开放权重第 2;LMArena 文本榜和视觉榜更新到 Nov 20,Neon 与 Claude Fable 5.2 (Max) 新上榜,但页面改版后采集只读到前 15 名,不能跟上期全表硬比。
最后仍是安全提醒,正文不给任何冒名或同名复制仓库的链接,也不把它们当作项目收录。搜索真实新模型名字时,可能被带到借用同一名字的假仓库或原样复制件。下载只认官方组织,不要运行来路不明的脚本。
深入学习建议
- Windows 与端侧开发者先看 Aion 1.0 Instruct 的卡片定位和 示例仓。
- 已在用 Qwen3.8-27B 的人读 DaisyRose-27B 博客,并把 harness-hub LoRA 更正后的 SWE-bench Pro 数字同步进自己的对照表。
- 看榜时只用 AA 模型榜 和 LMArena 文本榜 当期可见的前排,不要补写未读到的名次。
次要动态
- Palo Alto Networks 拟收购 Applied Compute:公司新闻稿落款 11 月 18 日,宣布拟以全股票 $4.5B 收购 Applied Compute,帮助企业在公有云或主权环境中安全地训练、适配和部署开源或开放权重模型。交易有惯例交割条件,预计于 Palo Alto Networks 2027 财年第三季度完成;Applied Compute CEO 预计交割后任联席首席 AI 官。@PaloAltoNtwks 在 11 月 19 日 05:22(Asia/Singapore)发帖。该公司同期财报数字不在此展开。
- Apple Depth Pro 2:苹果发布第二代单目度量深度估计模型,主打边缘锐利和视频帧间稳定,研究页为 Depth Pro 2,论文为 2611.26603,代码与权重在 ml-depth-pro-2 与 HF 说明页。单位为 Apple。发布 24M–872M 一簇模型及焦距估计器、Core ML 版;许可为 apple-amlr,仅限研究用途,不是 OSI 开源。页面日期为 11 月 20 日 08:00(Asia/Singapore),Apple 常见日级占位,精确时刻待核。上期已报的 Split-and-Scale 等不再重复;按
published日期,11 月 17 日及以后在 Apple 研究列表里看到的新条目主要就是这一项。 - FastFrames 与 Sage 的上期待核点:苹果 FastFrames 论文编号已出,为 2611.23226,仓库历史被重新压缩,但与上期保存的 tree 比对,权重 LFS 哈希未变,许可仍是仅限非商用研究的 apple-amlr。Sage S2.1 Flash 技术报告 的 v2 已改掉摘要里的“S1.5 Flash”笔误;HF 许可元数据仍为空,激活参数量仍无官方数字,AA 与 LMArena 仍未收录。
- SenseNova-Loop-9B 量化版已补齐:上期待核的官方 AWQ 版已出现,另有官方 GGUF 和 MTP 草稿权重,许可仍为 Apache-2.0,入口见 AWQ、GGUF 与 GitHub。主权重文件未变。“256K 上下文约 15GiB 显存”仍是官方数字,没有第三方复测。
- Kimi 与 Agnes:moonshotai/Kimi-K3.1-Pro 官方仓库和博客正文本窗口没有实质更新,旧版 Kimi-K3 加了指向 K3.1 Pro 的新版本指针;AA 仍为 46.5,开放权重第一。LMArena 文本榜虽刷新到 Nov 20,但改版后看不到它的名次。Agnes-2.5-Pro-Theta 的基座和许可问题仍无回应;同一账号新放了一个声明了 MiniMax-H3 基座与社区许可的视频改造实验,信号较弱。
- 其他新模型与论文:Reflection 的 Beam(2611.26358) 是本窗体量最大的开源模型技术报告,作者署名为 Reflection Team,501.3B 总参、23.4B 激活,预训练 23.8T token,后训练异步 RL 超过 1 亿条 rollout,安全结论在其框架下四类均为 Limited,摘要未列 SWE-bench 等绝对分,引用须回到正文表格。Kyutai 的 AURA 是实时音频驱动数字人模型,论文 2611.26540,许可为非商用,9.7fps 等数字待核。腾讯 WeMM-Video 是中英双语音视频联合理解系列,许可 Apache-2.0,论文 2611.26409,热度较低。社区对 Hy4 flash 的“少思考”编辑版属改造,不是官方,效果待核。DiffuSpace 的 Clover-35B-A3B-Preview(2611.24636)、Surge AI 对 Nemotron 3.5 Super 做分任务 LoRA RL 的 2611.22161(不是 NVIDIA 官方论文)、浙江大学的实验室孪生基准 TwinLab-Bench(2611.26248) 均为作者自报,备选记录。
- OpenAI 与 ChatGPT 其他:@OpenAIDevs 再次说明 ChatGPT Pro 200 可对 Sol 使用 Ultrafast,不改变上期已核的官方定价。AA 称 Astra / Sol 回复更短、结构更少,并给出词数变化,属 AA 自报。ChatGPT 正在向部分 Plus / Pro 用户测试 dots 与新的移动体验,目前是产品负责人口径,未见单独的官方帮助页列出全量开放时间表。Daybreak 本窗口未见新的官方定价或长复盘。OpenAI 另发了 Codex 沙箱、前沿风险管理等工程或政策长文;《The Silent Consensus》文首写明不代表 OpenAI 立场。
- Google 其他:Gemini 应用可用 Omni 1.2 Flash 生成 GIF,并扩到更低内存的 Android / Go 设备;本窗口未见 Carbon 或 Hydrogen 的官方改价。Qwen4-Max 上期已发布,本窗口主要是登陆更多第三方平台的宣传,未见官方改价。
- 实验室与工程:Amazon Science 介绍 AutoCorrode,经 MCP 把智能体接到 Isabelle,示例为经典证明,不是新的大规模自动形式化结果。Google Research 有量子语境性检验长文,不是语言模型发布。Meta 工程博客写了用 AI agents 规模化广告排序模型创新,以及模板化 ML 生态;研究博客本窗无新长文。NVIDIA 开发者博客有 Dynamo 降低 RL rollout 瓶颈 等工程文,无新的基础模型技术报告。Microsoft Research 本窗无新研究长文。Anthropic 研究列表可见的黑洞物理文标注为 11 月 17 日,早于本窗起点,不作为本期新发。
- 榜单(只能写读到的部分):AA Intelligence Index v5 新增 Gemini 4 Neon(Xhigh)61.4,闭源,默认视图排第 3,前两名仍是 Claude Fable 5.2 的 64.6 和 GPT-6.2 Astra 的 62.1。开放权重排序在 Hy4 改标后为 Kimi K3.1 Pro 46.5、Tencent Hy4 34.6、DeepSeek V4.1 Flash 1017 32.6、GLM-5.3 31.7、Inkling 2 Small 30.6、MiMo-V2.6-Pro 29.9;Inkling 2 Mini 有独立页面(20.1),不在默认视图里。LMArena 文本榜更新到 Nov 20(票数约 921 万,模型 426):前三为 Gemini 4 Carbon (High) 1527、Gemini 4 Argon (High) 1520、新上榜的 Gemini 4 Neon (High) 1513,Claude Fable 5.2 (Max) 以 1503 排第 7;上期还在前 15 的 Gemini 4 Hydrogen 与 Muse Spark 1.1 已不在本次读到的前 15 里。视觉榜更新到 Nov 20,第 1 仍是 Claude Fable 5 (High) 1309,Fable 5.2 (Max) 新上榜排第 2。页面改版后没有完整表、置信区间和票数,Kimi K3.1 Pro、Inkling 2 Small 等开放模型的名次本期看不到,不能跟上期全表逐行硬比。性价比前沿里可见的开放模型包括 MiMo-V2.6-Pro 1481、GLM-5.3-Flash 1475、DeepSeek-V4-Pro 1458。文生图榜与 AA 的文生图、图像编辑榜本窗口没有增减。
- 热度、数据集与补记:Haru-4B 升到 HF Trending 第 1,窗口内没有新 commit,上期关于延迟口径和缺少标准化对比的待核点仍无进展。MiniMax-H3-Image 退到 Trending 第 10。新数据集方面,乌兹别克语语料 为 odc-by,AgentAlphaXiv 为 cc-by-4.0,Kyutai 的 AURA 数据集为 cc-by-nc-4.0;LingSante-MedGuard 许可元数据为空,cmu-mocap-glb 为 license other。inworld/voice-isolator 与 Cloudflare/clairic 的首次发布早于本窗,不算本期新发;窗口内已出现 voice-isolator 的复制件。
- 待核、不升主条:AA 提到与千禧年大奖问题相关的宣称,并写明仍待独立验证,本稿不把任一宣称写成已解决。英伟达董事会讨论、入股传闻、杠杆 ETF 或供应链风险等,均未见本期交叉到的公司或监管文件,不写入已核事实。
- arXiv 状态:Asia/Singapore 11 月 18 日、19 日、20 日三批新稿与交叉列表完整扫描;11 月 21 日(周六)按常规无批。扫描自 2611.21612 起(上期周三批未放全的续扫点),全站新号止于 2611.26629。续扫 2611.26630+ 与下周一正式 listing。替换稿未当新条目精读。
来源与延伸阅读
- 资本与监管:Anthropic 定价新闻稿 · 424B4 索引 · SEC 公司页 · Nasdaq 新闻室 · Yahoo Finance 历史行情 · @AnthropicAI 定价帖
- Google:Gemini 4 Neon 发布文 · Neon 模型卡 · Project Genie 更新 · Genie 4 API · Genie 4 模型文档 · Tool Retrieval
- OpenAI:研究加速报告 · 芯片设计 · 对抗蒸馏 · MedChemBench · Performance Factory · GPT-Live-1.1 文档
- 论文:2611.25673 CompAct-Bench · 2611.25123 GrepMem · 2611.22971 SEAM · 2611.21832 · 2611.26358 Beam · 2611.26603 Depth Pro 2 · 2611.23226 FastFrames
- GitHub:ComfyUI v0.46.0 · Codex 0.171.0 · OpenAI Python v3.57.0 · OpenAI Node v7.62.0 · Unsloth v0.1.922-beta
- 模型与榜单:tencent/Hy4 · tencent/Hy4-flash · Tencent Hy License · Inkling 2 Mini · Inkling 2 Mini 发布文 · Aion 1.0 Instruct · DaisyRose-27B · harness-hub LoRA · AA 模型榜 · LMArena 文本榜
- 往期:上期深读(2026-11-18)
今日行动建议
- 写 IPO 或引用市值的读者:发行条款只抄 424B4 与公司新闻稿,把 $813.4 亿写成发行规模;行情用 Nasdaq / Yahoo 的开高低收;在出现交割 8-K 之前,不要写“已交割”,也不要采用未经核对的媒体市值。
- 在 Gemini 4 家族里选型的团队:把 Carbon / Neon / Hydrogen 的官方价、上下文和 AA、Cursor 各自标明来源的分数放在同一张表里,SWE-sweep 的 Antigravity 分不要当成裸模型分。
- 用 OpenAI API 的团队:对可等待任务,在预发环境比较 background mode 的 2 小时与 8 小时目标;语音会话把 Live 1.1 的 standby 与后端模型费用算进总成本。引用 14% PPA、23%→46% 或 54.0%→0.2% 时,一律标明官方自报。
- 想自托管腾讯权重的团队:先读 Tencent Hy License 1.0 第 10 节,判断自己是否属于年营收超 5,000 万美元或月活超 1 亿的 MaaS;内部自用不受此条约束。不要把 Hy4 写成 OSI 开源。
- 想在笔记本或单卡上跑新模型的人:优先试 Inkling 2 Mini,内存以官方 32GB 口径为准;已在用 Inkling 2 Small 做微调或批量推理的人,同步最新 chat template 与 generation_config。
- 已在用 Qwen3.8-27B 的人:可以把 DaisyRose-27B 直接替换对比;引用 harness-hub LoRA 时,改用更正后的基座 SWE-bench Pro 74.5%。
- 升 ComfyUI 0.46.0 或 Codex 0.171 的人:先确认不再依赖 DirectML,并分清云端模型目录标识、Codex / SDK 目录标识都不是新的开放权重。
- 所有人:下载模型只认官方组织,不要运行声称能“试用”“解锁”或提供“官方插件”的来路不明脚本;搜索新模型名字时,小心同名假仓。