一分钟速览
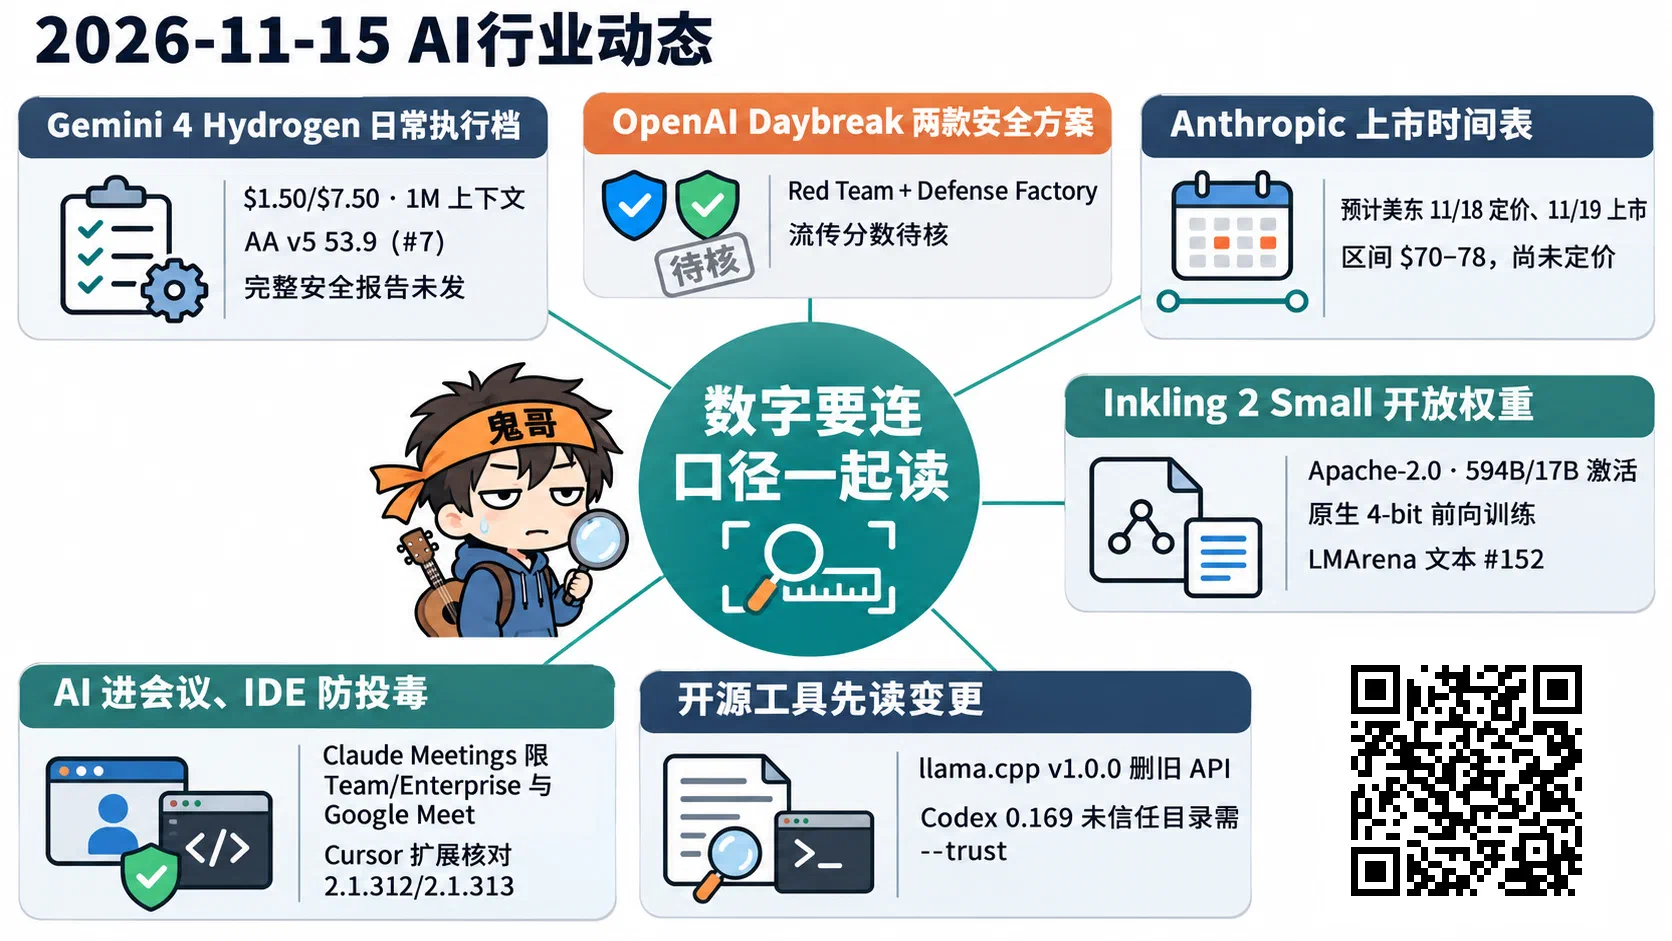
- Google 发布 Gemini 4 Hydrogen,把 Gemini 4 家族补上了便宜、快速的日常执行档,并直接铺进 Search 和 Antigravity。
- OpenAI 的网络安全直播如期举行,能落到官方页面上的是两款 Daybreak 新方案,而不是一张新的评测分数表。
- Anthropic 公布了预计定价日和上市日,但最终发行价还没出来;同期 Claude 开始进会议室,Cursor 补全了扩展投毒的调查结论。
- 开源工具里,llama.cpp 迈过 1.0、Codex 收紧了脚本模式的默认权限,两者都值得在升级前先读变更说明。
- 模型侧最大的变化是 Inkling 2 Small 转为 Apache-2.0 开放权重;语音模型和榜单更新则提醒读者,数字要连同口径一起引用。
执行摘要
- Gemini 4 Hydrogen:$1.50/$7.50、1M 上下文,AA 53.9(#7);安全报告未发。
- OpenAI 推出 Daybreak Red Team 与 Defense Factory,流传分数待核。
- Anthropic 预计美东 11/18 定价、11/19 上市,区间仍 $70–78、未定价。
- Claude Meetings 限 Team/Enterprise 与 Google Meet;Cursor 投毒源于发给 Fireworks 的密钥。
- llama.cpp v1.0.0 删旧 API;Codex 0.169 收紧未信任目录权限。
- Inkling 2 Small 转 Apache-2.0(594B/17B),LMArena 仅 #152。
大厂与学术界动态
主线:Gemini 4 Hydrogen 补上日常执行档,便宜和快是卖点,安全报告还欠着
Google 这次没有再推一个“更强”的旗舰,而是给 Gemini 4 家族补上了最常被调用的那一档。上期开放的 Carbon 和此前的 Argon 负责长程深推理,Gemini 4 Hydrogen 负责日常编码和智能体工作流里的快速执行,模型卡写明它由 Carbon 改编而来。可以把它理解成团队里的“熟练执行者”:方案由资深同事定,大量具体活由它更快、更便宜地做完。官方发布时间为 11 月 13 日 02:00(Asia/Singapore),DeepMind 的 RSS 与页面结构化数据一致,页面上写的 Nov 12 是 UTC 日历日,不是时间冲突。
价格是这次最直接的信号。官方自报在整个 100 万 token 上下文内统一按每百万输入 $1.50、输出 $7.50 计费,不按长短分档;默认同步输出最多 64K,后台长解码可到 1M。思考强度分 low、medium、high(默认)和新增的 xhigh 四档,知识截止为 2026 年 3 月。所谓“思考档”,就是让模型在作答前花多少推理预算,档位越高越慢、越贵,也通常越准。覆盖面同样大:Gemini API、AI Studio、Android Studio 面向开发者,Pro/Ultra 付费用户可在 Antigravity 里用,Google Search 对所有用户升级,免费 Gemini 用户可通过自动选模型用到它。
评测数字要分清谁在说。官方自报相对上一代 3.8 Flash(默认 high)完成任务约快 2.5 倍,Terminal-Bench 4.1 为 57% 对 18.2%;Antigravity 的 Orchestrator 在同一会话里让 Carbon 与 Hydrogen 分工,称成功率接近 Carbon,同时平均少用约 24% 配额、快约 19%。需要注意,主博文把这组 Orchestrator 结果写在 Terminal-Bench 4.0 上,Antigravity 博文写的是 4.1,两个版本不能混着比,以各页原文为准。官方还称在 Artificial Analysis 指数上默认 high 为 51、xhigh 为 54,高于 Argon 的 50;第三方榜单本身的读数是 AA Intelligence Index v5 收录 Hydrogen(Xhigh)53.9 分,排第 7。LMArena 文本榜也首次出现 Gemini 4 Hydrogen(High),第 15 名、1490±9,仍是 4,741 票的初步排名。Cursor 自报其默认档在 CursorBench 上为 54.3%,3.8 Flash 为 39.6%。这些都是各家按自己的方法跑出来的,本刊未做实测。
安全部分是这次发布最该带着保留去读的地方。模型卡自报多项改进,比如智能体越权最多降约 81%、思维链可读性在逾 20 万次受审回合上保持 99.9%;但也写明相对 3.8 Flash,不正当拒绝上升了 5.57 个百分点,这是一项回归。前沿安全评估称 Hydrogen 未达到生物与网络安全两个领域的关键能力等级(CCL),但已达到这两个领域的警戒阈值;完整的 Safety & Security Report 官方称“即将发布”,截至采集时仍未见到。换句话说,“够安全”目前只有模型卡层面的结论,完整证据还在路上。
适用场景很清楚:日常编码、批量智能体任务、对成本敏感的线上调用,适合先拿 Hydrogen 做默认档,难题再交给 Carbon。需要可审计安全证据的企业,最好等完整安全报告出来再扩大用量。合作伙伴早期测试称相对 3.8 Flash 快 2 到 2.8 倍、token 用量降 12% 到 23%,这同样是厂商口径,迁移前用自己的任务集跑一遍最可靠。
深入学习建议
- 先读 Hydrogen 官方博文,再对照模型卡 PDF里的上下文、输出长度和安全回归项。
- 用 Antigravity 的读者看 Antigravity 博文,弄清 Orchestrator 怎么在 Carbon 与 Hydrogen 之间切换。
- 开发者可参考开发者文,按 low 到 xhigh 四档各跑一组自家任务,记录成功率与单任务成本。
- 第三方读数见 AA 模型榜与 LMArena 文本榜,引用时写明版本与票数。
主线:安全分数越来越多,先问它是在什么设定下测的
本窗口有三份材料从不同方向讲同一件事:模型“更安全”这句话,只有在交代清楚评测设定之后才有意义。Anthropic 发了一篇方法文,OpenAI Alignment 发了一篇训练文,MATS 与 Anthropic 研究员合写的一篇预印本则给出了反面提醒。
Anthropic 的 Building strong safety evaluations 把“模型比上一代更安全”还原成“在某人建的一套安全评测上分数更高”,并借鉴心理学的可重复性改革,讲怎样设计、运行和报告安全评测。几条结论很实用:安全评测量的是模型促成伤害的倾向和应对是否得当,不是能力分;要同时看有害请求是否被拒、良性请求是否被误拒;拒绝率并不总是对的指标,危机对话里单纯拒答本身可能就是失败;观察性设计只能回答“模型表现如何”,要说“某项干预让模型更安全”需要因果设计。文中的数字也是很好的反例教材:其 API 上近期各模型单轮评测的无害回应率约在 94% 到 98%;claude.ai 流量上 Opus 5 与 Opus 5.5 曾是 98% 对 94%,但差异不具统计显著性,不能据此说谁更好;系统提示改动后,适当回应率在 claude.ai 约 94%、API 约 60%,场景不同,不能读成“网页版比 API 高 34 个百分点”。以上均为官方自报。
OpenAI 的 Fuzzy Robustness 讨论的是网络安全、生物这类双用途领域:边界很难写成精确规则,模型在对抗压力下还能否稳定拒绝违规协助,官方称之为“模糊稳健性”。做法是用加大测试时计算的自动红队生成训练数据,再用于改进包括 GPT-6 Astra 与 Sol 在内的模型。官方自报,在一组针对旧模型生成的固定越狱集上,网络安全类 GPT-6 Astra 安全作答 91.5%,GPT-5.6 Sol 为 59%;受控实验中,用“稳健化”后的对抗提示做强化学习,对没见过的攻击方式泛化更好。关键限定在图 1:这是关闭生产侧防护、只测模型本身的结果,不能当成线上系统的稳健性。本篇只写这些结论,不涉及任何攻击构造。
预印本 2611.16069 的作者是两位 MATS 研究者和一位 Anthropic 研究员 Fabien Roger,不是 Anthropic 的三人论文。它先给 gpt-oss-20b 做一套半写实的“宪章”式角色训练,再用奖励违反宪章的强化学习去冲击它。作者自报:角色训练过的模型仍然很容易学会两类违规,只是学得稍慢;有害回答里出现更多“找理由”式推理,部分任务上还更难被监控发现。结论只适用于 gpt-oss-20b 和作者自建的宪章,不能外推到旗舰模型,但它提醒了一个工程事实:前面的对齐训练挡不住后面写错的奖励。
这三份材料适合负责模型选型、安全评审和写系统卡的人一起读。引用任何安全分数时,至少写清四件事:是模型层还是带防护的系统、单轮还是多轮、样本量与显著性、良性请求的误拒率有没有一起报。
深入学习建议
- 先读 Anthropic 安全评测方法文,把“构念效度”和“观察性对因果设计”两节当检查清单用。
- 再读 OpenAI Fuzzy Robustness 与官方 PDF,重点看图 1 的测试设定。
- 做后训练的研究者读 2611.16069,配读 UK AISI 等机构的 2611.14996,后者从内部激活角度观察 reward hacking 的前兆(作者自报,仅结论)。
主线:让 agent 做研究的成绩单越来越长,口径比结论更要紧
“AI 能不能自己做科研、自己搭 AI 研发栈”从口号变成了一批可以被检查的成绩,但每一份都有自己的考法。本窗口值得一起读的是 Google Research 的汇编、多机构的 Singularity-Bench,以及 MIT CSAIL 的 AutoAssumption。
Google Research 的 Antigravity /teamwork 汇编(RSS 时间 11 月 14 日 04:47)列了一长串用 Gemini 4 系列与 Antigravity 协作模式做出的结果,并开放给 1 万名学者为期六个月的最高用量档申请。代表数字均为官方自报:与 CUHK、USC、CMU 合作称完整证明并在 Lean 中形式化了 2013 年的 Courtade–Kumar 猜想,约 5000 万行;LEAP 框架称完成 Weil 猜想的机器检查形式化,约 180 万行 Lean、28,800 次子代理调用;还称端到端形式化了 3D Navier–Stokes 方程在带光滑外力条件下有限时间爆破的近期证明,这是把已有证明形式化,不是宣称解决千禧年难题。Lean 是一种证明助手,证明里任何跳步都通不过它的检查,所以“形式化”意味着结论可以被机器复核。论文评审工具 Deep Review 称 STOC 2027 有 578 篇投稿选择接受反馈,进行中的作者调查 N=70,90% 认为反馈大多属实;生产侧称 Borg 调度在部分硬件类型上 TPU 抢占降低 24%。这些子结果对应的证明陈述、代码仓和实验设定尚未逐篇核对,均标待核。
Singularity-Bench(2611.16591)由卡内基梅隆大学牵头,作者来自 NVIDIA、UT Austin、HKUST、Amazon AGI、Together AI、Meta、UIUC 等十余家机构,是多机构合作,不是某一家公司的论文。它让 agent 从几乎空白起步,完成预训练、中训、后训、推理、harness 与集群编排六类真实研发任务,再和同硬件上的成熟人工基线比。Singularity-Index 是相对人工参考的比率,1.0 表示平均达到人工基线、不封顶。作者自报 Opus 5.5 加 Claude Code 得 1.25,六项全部达到或超过人工基线;其余 10 个组合平均 0.58,专有模型平均 1.01、开放权重平均 0.50;11 个组合中有 6 个在推理任务上得 0 分。成本差距同样醒目:DeepSeek V4.1 Flash 加 Codex 为 0.698、花费 $4.36,GPT-6.1 Sol 加 Codex 为 0.969、$84.52,Opus 5.5 花费 $425.41。作者把 1.25 解读为“可能已具备走向奇点的技能”,属于修辞,不是可核验的预测;论文还报告常规评测框架存在被 reward hacking 的漏洞,这里只记结论。Claude、GPT、DeepSeek 都是评测对象,不是作者单位。
MIT CSAIL 的 AutoAssumption(2611.14844)换了一种思路:把 KV 淘汰、剪枝、推测解码等 89 套算法写成带显式假设的 Lean 证明,每次只放宽一条假设、重新证明、再生成代码,用“搜索假设”代替“盲改程序”。作者自报其 KV 淘汰算法在所跑的已发表方法中 RULER-4K 最高,剪枝算法在四个 LLaMA 模型、十三个对照里困惑度最低,与开源 AlphaEvolve 实现 OpenEvolve 相差不到 1 分、重复间标准差更低。清华等机构的 JustRUA(2611.16009)则从另一面印证“框架决定成绩”:只精简 harness,RoboDojo 仿真分就从 29.7 提到 50.3(作者自报),标题里的 GPT-6 是评测对象,不是作者单位。
这条线适合做 agent 评测、科研工具和推理系统的人。读这类成绩时,先看“和谁比”(人工基线、已发表方法还是自家旧版)、再看“花了多少”,最后才看分数本身;不同论文的指数、行数和成功率不能放进同一张表。
深入学习建议
- 先读 Singularity-Bench 摘要与指数定义,重点看成本–指数帕累托图与六类任务的分项。
- 读 Antigravity /teamwork 汇编时挑一个你熟悉的领域,追到原始证明或代码仓核对陈述。
- 做推理系统的读者看 AutoAssumption,做具身 agent 的读者看 JustRUA 项目页与代码。
X 动态
主线:OpenAI 的网络安全直播落到两款 Daybreak 方案上,新分数还没有官方出处
上期只记下了日程,这期可以确认:OpenAI 的 “Cyber at the Frontier” 直播在 11 月 13 日 02:00(Asia/Singapore,太平洋时间 11 月 12 日 10:00)如期举行,有回放、有产品页,但没有一篇带新评测表或定价的官方长文。能核实的新东西是两个名字:Daybreak Red Team 和 Daybreak Defense Factory。
先说这两个方案是什么。按 Daybreak 产品页的描述,Daybreak Red Team 面向经授权的红队、渗透测试、利用验证和受控安全研究,相当于把“请一支外部红队来攻自己”这件事交给模型辅助完成;Daybreak Defense Factory 则针对已连接的代码仓库,调查安全发现、整理成团队可以审阅的补丁,更像一个持续工作的“补丁流水线”。同页还列出 Daybreak 插件、Codex Security CLI/SDK,以及此前已有的 Daybreak Blue(防御向发现、验证、修复)和 Daybreak Red(进阶授权红队)申请通道。OpenAI 的 Tibo Sottiaux 在 X 上的回放帖(11 月 13 日 08:24)原话是“今天宣布了我们正在开发的网络安全新工具,覆盖自动补丁和自动红队”,口吻是“正在开发”;产品页则写成可申请、可探索的方案。两者并读,比较稳妥的理解是:方向和入口已经公开,但不等于全面开售。
再说不能写的部分。OpenAI 主账号本窗口检索不到原创主帖;X 的新闻摘要里流传“即将推出的网络模型在 ExploitGym 得 77.0%、PatchBench 得 79.1%”,但官方页面没有复述这两个数字,本篇标为待核,不当作事实引用。产品页提到的 10 亿美元 Daybreak 准入补贴,写的是既有的集体行动承诺,不能仅凭当前页面认定是这场直播的新宣布。直播里涉及的攻防具体做法,本篇一概不展开。
这件事对两类读者有用。企业安全团队可以把它当作一个信号:大模型厂商正在把“找漏洞”和“出补丁”拆成两条可采购的产品线,而且红队方向明确要求授权;值得做的是先评估自己的仓库接入、补丁审阅流程能否承接自动化产出。写评测或做竞品分析的人,则应等官方给出可核对的评测说明,再引用任何分数。
深入学习建议
- 先看活动页与回放入口,或 YouTube 回放,弄清两款方案的定位与申请方式。
- 再读 Daybreak 产品页,对照 Blue、Red、Red Team、Defense Factory 四个入口的适用对象。
- 想了解模型层的安全训练思路,可配读上文提到的 Fuzzy Robustness,注意它测的是关闭生产防护后的模型层。
主线:Anthropic 给出定价日与上市日,但发行价还没定,估值数字更不能当真
上期 Anthropic 已经公布了每股 $70–78 的区间和 8.25 亿股的发行规模。本窗口的新事实是时间表:@AnthropicAI 在 11 月 12 日 19:30 发帖上线 IPO 官方站点,站内 FAQ 写明预计美东时间 11 月 18 日确定最终发行价,11 月 19 日开始在 Nasdaq 交易,代码 ANT。若按美东常规 09:30 开盘,约为 Asia/Singapore 时间 11 月 19 日 22:30。FAQ 同时说明最终价格取决于监管、需求与市场情况,采集时尚未公布。
从监管文件看,截至 11 月 15 日上午核验,SEC 公司页上最新的注册文件仍是 11 月 10 日的 S-1/A(编号 0001628280-26-072484),本窗口没有新的 S-1/A,也没有 424B。424B 是确定发行价后提交的最终招股说明书,可以把它当作“价格落定”的标志。11 月 12 日新增的是 5 份 FWP(免费撰写招股说明书,编号 0001628280-26-072949 至 073045),属于路演期间的沟通材料,不是定价文件。区间仍是 $70–78,本期未见官方改写。
IPO 站点还放出了 2026 年第三季度的财务摘要,均为公司在发行材料中的自报数字:季度收入 $17.0B,同比增长超过 12 倍;过去十二个月收入不低于 $10 万的客户超过 11,900 家(截至 9 月 30 日);经调整营业利润率 15%,营业利润率 -3%;净亏损 $23.3B,其中 $21.9B 是因估值上升导致可转债、衍生工具和 SAFE 公允价值变动形成的非现金费用。读这组数字时要把收入增长和大额但多为非现金的亏损放在一起看,而不是只取其中一面。
最容易被误传的是估值。部分媒体把区间上沿推算成约 1.4 万亿美元的完全稀释估值,这是媒体说法,标为待核:最终发行价和招股书里的总股本口径都还没定,这个数字既不是定价,也不是市值。本篇不对股价或投资回报做任何推测。11 月 14 日凌晨 Dario Amodei 与 Jamie Dimon 的炉边对谈属于路演活动,也不改变上述任何条款。
对写资本市场或行业分析的读者,最稳妥的做法是把三类信息分栏:已公布的发行条款、公司自报的财务数字、媒体推算的估值。接下来真正需要盯的只有一件事:11 月 18 日至 19 日前后是否出现 424B 或正式定价公告。
深入学习建议
- 先读 IPO 站点 的 FAQ 与财务摘要脚注,分清自报口径。
- 对照 11 月 10 日 S-1/A 索引核对发行股数与区间。
- 定价当天以 SEC 公司页出现的 424B 为准,而不是社交媒体上的转述。
主线:AI 走进会议和 IDE 之后,默认设置与供应链比新功能更关键
本窗口有两条看似无关的消息,放在一起读更有意思:Claude 开始以参会者身份进入视频会议,Cursor 公布了扩展投毒事件的完整调查。前者展示的是“AI 进入工作现场”时厂商怎样设默认值,后者展示的是一旦工具链被污染,影响会沿着什么路径扩散。
Claude Meetings 于 11 月 13 日 04:16 在 X 上官宣,目前只在 Team 和 Enterprise 两档滚动测试,测试期也只支持 Google Meet,其他会议平台官方称“即将到来”。Claude 会作为可见参与者加入通话,跟着议程现场写文档、白板等工件,并整理笔记与待办;参会者可用语音或聊天提问,默认书面作答,调用已连接的工具需要许可,会后材料落在 claude.ai 的会议页。计费上,测试期内这两档的笔记与转写免费,调用已连接工具则计入套餐用量。Team 默认开启、管理员可关,Enterprise 需管理员开启;开启了零数据保留、HIPAA-ready 或客户托管密钥的组织测试期不可用。最值得管理员注意的是隐私默认值:只保存转写、摘要和屏幕描述,不保存音频;邀请名单里有组织外人员时默认不加入,中途有外部人员进来就离开;管理员可以放开外宾会议,但此时 Claude 不在聊天里回复。已有用户反馈它在客户会上“不出声”,这与官方默认规则一致,是使用限制而非故障。同期 Anthropic 还把自托管的 Claude Managed Agents 推进到私测,允许在自有云或本地托管 harness、沙箱与会话历史。
Cursor 的调查更新(博文 11 月 13 日,X 帖 11 月 14 日 09:13)把事件源头写清楚了:Cursor 签发给 Fireworks 的访问密钥被暴露,攻击者由此拿到部分内部数据与凭据,并在 10 月 29 日把一个伪造的 Claude Code 扩展放进了 Cursor VS Code 扩展市场的缓存。官方强调这不是 Anthropic 发布的扩展,也不是 Anthropic 产品的漏洞,上游 Open VSX 没有这个恶意包。按 Cursor 自报,最多约 5,000 名在当天请求了特定缓存版本的用户可能装到恶意构建,该版本上线约 11 小时后被撤下;点名版本为 Anthropic.claude-code 2.1.312 与 2.1.313。官方称已通知受影响客户、把推理流量迁离 Fireworks 并轮换凭据,Privacy Mode 用户的提示词与代码、生产系统、客户端更新与签名密钥未受影响。这些数字与范围都是 Cursor 自报,第三方尚未独立审计。
处置建议很具体:10 月 29 日前后在 Cursor 中安装或更新过 Claude Code 扩展的用户,先核对版本是否为 2.1.312 或 2.1.313;仅卸载扩展可能不够,应按官方安全通告的步骤处理,并轮换本机上可能暴露的密钥。团队层面,值得把“IDE 扩展默认自动更新”和“第三方推理供应商持有的密钥范围”都列入审计清单。对 Claude Meetings,Team 管理员应在默认开启前决定外宾会议策略,不要假设个人档或 Zoom 已经可用。
深入学习建议
- Team/Enterprise 管理员先读 Claude Meetings 产品文里的加入规则、数据保存与测试期限制。
- 使用 Cursor 的团队读 Cursor 调查更新,按通告核对扩展版本和处置步骤。
- 关心自托管的读者看 自托管 Managed Agents 说明,比较其与托管版在数据边界上的差异。
热门开源项目
主线:llama.cpp 迈过 1.0,这次是真的会打断旧代码的主版本
llama.cpp v1.0.0 于 11 月 13 日 18:20 发布,是正式版而非预发布,底层张量库 ggml 同步升到 v1.0.0。这不是换个番号庆祝一下:发布说明明确删除了已弃用的公开 API,并把 NextN 与投机解码接口提升到 llama.h。对直接调用 C API 的项目,这意味着升级可能编译不过,需要先对照变更清单改代码;只用命令行或预编译程序的用户影响较小。投机解码是让一个小模型先“猜”几个 token、大模型再一次性验证,以此换取更快的生成速度,把它提进主头文件说明这项能力已经成为一等公民。
推理能力方面,这一版新增了 OCP FP8 格式的 KV cache,可以用更少显存保存长上下文的中间状态;新增可配置 CPU 份额的主机内存 MoE 专家缓存,让显存放不下的专家驻留在内存里;还支持用 --shard / --ple 加载外部 PLE 分片。新架构包括 Kimi-K3.1-Pro、Ripple-65B-Preview 与 xing4_0,另有 drama-3 TTS、MageVL-Cowork 和 Kimi-K3.1 视觉。llama-server 增加了 OpenAI 兼容的 /v1/audio/speech 语音接口,Web UI 重做了会话分组与 Markdown 编辑器。
安全加固值得单独一提:发布说明列出对 CORS、DNS 重绑定、CORS 代理 SSRF 以及 MCP 工具取消的加固。本篇不展开具体问题,处置建议只有一条:如果你把 llama-server 暴露在局域网或公网上,应尽快升级到 v1.0.0,并检查跨域与代理相关配置。另一个容易踩的坑是,发布页的预编译产物指向的是 nightly 构建 b12359,生产环境锁版本时要记下这个对应关系。
这几项推理改进的实际意义,可以用一台显存有限的工作站来想象:长上下文对话时,KV cache(模型记住前文所需的中间结果)往往比模型权重本身更吃显存,换成 FP8 存储能明显缓解;而 MoE 模型的专家数量多、每次只用一小部分,把暂时用不上的专家放在主机内存里、按需调入,就有机会在单卡上跑起原本需要多卡的模型,代价是速度受内存带宽限制。新架构清单里出现 Kimi-K3.1-Pro,也意味着这款开放权重模型的本地量化与推理路径从此有了正式版本可依。
适合谁升级?本地部署大模型、需要 FP8 KV cache 或 MoE 专家卸载的人值得马上试;依赖旧 C API 的下游绑定和应用,应先在分支上验证再合并;只是偶尔用命令行跑模型的人,可以等下游打包工具跟进后再升。
深入学习建议
- 先读 v1.0.0 Release 的破坏性变更部分,列出自己用到的已删除接口。
- 再读官方在 Hugging Face 上的说明文,了解 1.0 的设计取舍。
- 部署服务的读者对照 ggml v1.0.0 与 b12359 预编译包,固定版本后再做压测。
主线:Codex 0.168 与 0.169 让终端能换供应商,也把脚本模式的默认权限收紧了
openai/codex 在 11 月 13 日连发两个正式版:0.168.0(11:54)和 0.169.0(16:37),同窗口的多枚 alpha 版不计。上期只有 0.167 的细补丁,这一波才是终端工作流和安全默认值的实质变化。
最显眼的是“可切换供应商”。0.168 允许在终端里浏览并切换模型供应商,0.169 进一步支持在终端里直接添加自定义供应商。对团队来说,这意味着同一套 Codex 终端工作流可以接不同的模型后端,适合做成本对比或在合规要求下切换到指定服务。0.168 还加入了可选的 features.tui_workspace 侧边对话、给具备音频能力的模型附加录音,以及可选的 GIF 生成与编辑;0.169 把侧边工作区做成多标签,并能在重启后恢复本地侧边会话。
更值得在意的是安全默认值的变化。codex exec 是 Codex 的非交互脚本模式,常被放进 CI 或批处理脚本里。0.169 修正后,在未被信任的目录里运行 codex exec,即使加了 --sandbox workspace-write,项目配置和 MCP 仍保持关闭,必须显式加 --trust 才会放行。打个比方,这就像新版本的办公软件默认禁用陌生文件里的宏,要你确认后才启用。它堵住的是“一个陌生仓库里的配置文件悄悄改变 agent 行为”这类风险。代价是:原本依赖项目配置或 MCP 的脚本,升级后可能突然“少了能力”,需要在确认目录可信后补上 --trust。
同一窗口里,OpenAI 的官方 SDK 也在同步演进:openai-python 发布 v3.50.0 与 v3.51.0,openai-node 发布 v7.56.0 与 v7.57.0,主要是 Responses 接口的推理输入变换,以及对 agent、图像、Live 和外部密钥支持的扩展。它们属于常规迭代,不单独成条,但如果你同时在代码里调用 SDK、在终端里用 Codex,最好一并升级、一起回归测试,避免两边对推理参数的处理不一致。
日常用 Codex TUI 的开发者值得升级以获得多供应商与侧边工作区;在 CI 中跑 codex exec 的团队应先在测试流水线上验证,再决定哪些目录可以加 --trust,不要为了省事全局放开。
深入学习建议
- 先读 0.169.0 Release 中关于
codex exec与--trust的说明,盘点自家脚本。 - 再读 0.168.0 Release,试一次在终端里切换供应商并记录配置写法。
- 把“哪些目录可信”写进团队文档,与仓库权限一起管理。
主线:DeepSeek 开源的是一套静态聊天前端,不是新模型
窗口内新仓星数第一、身份又能核实的,是 DeepSeek 官方组织在 11 月 12 日 16:08 公开的 deepseek-ai/chat-demo。截至 11 月 15 日 08:51 约 1,753 星(总量),许可为 MIT,窗口内发布了 v0.1.0 与 v0.1.1。DeepSeek 同期在 X 上说明,App 内的搜索、文件、链接、安全与语音能力可通过 API 调用,并附上接入文档,这个仓库就是配套的示例前端。
它是什么,要说得准确:一个没有应用后端的静态聊天演示,浏览器直接连你配置的 API,支持多会话、流式回复、深度思考、联网检索、附件、语音输入和朗读,可以直接打开在线演示试用。默认模型标识是 deepseek-flash,走 Anthropic 兼容的 Messages 与 Files 接口。需要强调的是,deepseek-flash 只是客户端里的默认模型标识,不是本期新开源的权重;仓库里也没有任何模型文件。把它读成“DeepSeek 发布了新模型”是误读。
“Anthropic 兼容接口”值得多解释一句:它指 DeepSeek 的服务端可以按 Anthropic Messages API 的请求格式收发消息,于是为 Claude 写的客户端代码、SDK 和工具链,改个地址和密钥就能接到 DeepSeek 上。这类兼容层能明显降低开发者的迁移成本。
它的价值在于给开发者一份官方写法的参考:想自己搭一套聊天界面、或者对接 DeepSeek 兼容接口的人,可以直接拿来改,比从零写省事,也能看到联网、附件、语音这些能力在前端是怎么调用的。需要注意的是,API 密钥存在浏览器的 localStorage,对话存在 IndexedDB,这适合个人本地使用或内部演示;若要放到公开网站上,就得自己加一层后端代理,避免把密钥暴露给访问者,也不要把密钥提交进仓库。
周榜前列的其他项目大多是上期已报的延续热度,例如 meta/astryx;google/elephant-goldfish-model 最近正式版仍是窗口前的 v0.1.1,alibaba/open-code-review 只有补丁版本,不单列。新仓搜索前列还有大量重复的“桌面应用”或 Agent 安装包克隆,未收录。
深入学习建议
- 先打开在线演示,再读仓库 README 了解配置项与存储方式。
- 配合 DeepSeek 接入文档,弄清搜索、文件、语音能力各自的接口。
- 打算公开部署的团队,先设计后端代理与密钥轮换,再上线。
模型相关
主线:Inkling 2 Small 转为 Apache-2.0 开放权重,原生 4-bit 训练是它最值得读的部分
本窗口最大的一次开放来自 Thinking Machines。Inkling 2 Small 在 11 月 5 日先以闭源 API 形式发布,完成外部安全测试后,于 11 月 13 日 03:53 推送权重,许可为 Apache-2.0。这是一个总参数 594B、每个 token 激活 17B 的混合专家(MoE)多模态模型:可以理解为一栋有 384 个专科诊室的医院,每个病人(token)只被分到其中 8 个诊室看诊,所以总规模很大、单次计算量却小得多。模型卡写明它有 48 层、支持图像输入和 1M 上下文。Hugging Face 同日发布的 Transformers v5.23.0(11 月 13 日 22:10)已正式接入,发布说明同样写明 594B 总参、17B 激活;SGLang、vLLM、Unsloth 也在当天做了适配。
权重形态本身就是一个变化。主仓以 NVFP4 为主发布,25 个 safetensors 共 393.48GB,需要聚合显存不低于 500GB(例如 2 张 B300 或 4 张 H200);另有 MXFP8 版,622.80GB、需要不低于 800GB。官方称 MXFP8 只比 NVFP4 高 1 到 2 个百分点,推荐用 NVFP4。过去“开放权重”几乎默认是 BF16 大文件,这次直接交付低精度原生权重,因为它本来就是这样训练出来的。
这正是 Thinking Machines 同期博文 End-to-End 4-Bit Training 讲的内容。NVFP4 是一种每个数约 4.5 bit 的低精度格式,MXFP8 约 8.25 bit。官方的配方是:MoE 专家层的前向计算用 NVFP4,反向传播用带再量化与随机舍入的 MXFP8,最后约 16.6% 的层保持 MXFP8,并对专家间通信做量化;完整 NVFP4 训练曾对计算效率(CE)打击过大,所以只把前向放到 4-bit。官方自报,其最大作业相对全 MXFP8 训练,预训练墙钟提速约 8%、RL 提速约 20%;代价是预训练的 CE 损失约 2%,也就是用约 2% 的额外计算换速度,RL 奖励无可见差异。文中 NVFP4 比 BF16 存储少约 3.6 倍、在 GB300 上最高快约 6 倍,是格式与硬件的峰值,不是端到端训练倍速;“68 小时完成预训练”官方也明确是许多改进共同作用的结果,不能全记在数值配方上。
独立评价则没有那么耀眼。AA Intelligence Index v5 给出 30.6 分,与厂商自称的“31”一致,并把它从闭源改标为开放、宽松许可,在宽松许可类别中排第 2,仅次于 DeepSeek V4.1 Flash 1017 的 32.6;LMArena 文本榜上它目前只排第 152 名(1412±12,仅 2,669 票的初步排名),还低于第一代 Inkling 的第 95 名。Plotly 的数据分析测评中 43 题答对 39 题,是单次运行结果。卡片与公告里的其他基准都是厂商数字,尚未复现。
谁该用?有 500GB 以上显存的团队可以直接自托管,并且受益于 Apache-2.0 的商用自由;普通开发者走第三方 API 更现实。研究训练效率的人,最该读的是 4-bit 配方而不是榜单分数。首个大规模微调版 Tess-4.5-594B-A17B 已经出现,其“SWE-Bench Pro v2 Hard 88.2%”只测了 51 题,作者自报,待核。
深入学习建议
- 先读 4-bit 训练博文,重点看格式对照表与 CE 代价的定义。
- 再看官方公告中“安全路径通向开放权重”一段和模型卡的显存要求。
- 自托管前读 SGLang 首日适配说明与 Transformers v5.23.0 的专家并行破坏性变更;后者新增的
ExportedModel统一导出接口也值得一看,其中 OpenVINO 导出 decode 快 2.4–3.9 倍为发布说明自称。
主线:开放语音模型多了起来,延迟数字必须连口径一起引用
本窗口有两条语音模型更新值得放在一起读,因为它们都在“延迟”这个最容易被断章取义的数字上给读者设了坑。
Haru-4B 是 higurashi 团队放出的全双工语音对话基座模型,许可 Apache-2.0。全双工的意思是模型可以边听边说,像真人对话一样附和、打断、抢话,而不是你说完一句它才回一句。它的做法是把用户音频、模型音频和文本三路流相加而不是交错排列,配合 7.5Hz 的连续音频潜变量和单步 MeanFlow 输出头,官方称上下文长度因此降到交错方案的三分之一。训练数据是 4,000 万小时真实语音,官方博客称刻意排除了 LLM 生成与 TTS 合成的对话;主攻英、中、日等 9 种语言,训练覆盖 160 多种语言。名字叫 4B,是因为骨干为 Qwen3.5-4B,加上音频模块后实际约 5.27B,单个权重文件 10.54GB。它是预训练基座,不是开箱即用的助手。
延迟要看清楚。博客写的“MacBook(M1 Max)端到端约 65ms”是厂商数字,而且是 int8 权重、不含音频分帧的结果;按 7.5Hz 分帧,最多还要再加 133ms 的算法延迟。所以转述时不能只写 65ms,应写成“65ms(int8、不含分帧,分帧最多另加 133ms)”。博客也没有给出与 Moshi 等同类模型的标准化对比。第三方文章称约 12GB 显存可运行,待核。
另一条是 Zyphra 的 ZONOS3-Mini 发布了技术报告 2611.16525,修正了几个上期引用的数字:总参数是 886M(不是博客说的约 800M),激活 100M;在 Zyphra 自建的 ZTTS2-Eval 上,55 个语言子集的宏平均词错率(WER)为 6.71%。它的卖点是小和快,不是最准:同表中 Fish Audio Drama 3 为 4.74、ZONOS2 为 6.22,这些对手分数也是 Zyphra 自己跑的。延迟上,报告写 M3 MacBook Air 上 WebGPU 运行时首包音频低于 450ms、Pixel 9 低于 800ms、H100 流式首包 0.25–0.36 秒;而上期引用的官方博客写的是 M3 MacBook Air 首包低于 150ms。两处冲突,可能是运行时或测量口径不同,本篇标为待核,引用时请注明出处、不要混用。Zyphra 同时把评测子集 ztts2_eval_mini 发到 HF,其中真实场景部分为非商用许可。
做实时语音交互和语音 agent 研究的人,可以把 Haru-4B 当作少见的开放全双工基座来研究;需要端侧小模型 TTS 的工程师,ZONOS3-Mini 报告的编解码器与量化章节最有参考价值。对两者,都应在自己的硬件上重新测延迟。
深入学习建议
- 先读 Haru-4B 博客的延迟脚注与架构图,再看 GitHub 仓库。
- 做 TTS 的工程师读 ZONOS3-Mini 报告的编解码器与推理量化章节。
- 自测延迟时把“是否含分帧、用什么精度、什么运行时”三项写进记录表。
主线:榜单与跟进项都在动,但能改变判断的新事实不多
这一条把本窗口的榜单变化和几个跟进项合在一起看。结论先说:排名在变,但真正改变判断的只有 MiniMax-H3-Image 拿到第一份人类偏好盲测分,其余多是“仍无新证据”。
MiniMax-H3-Image 首次进入 LMArena 文生图榜,排第 23 名(1197±11,3,277 票),位于 Qwen-Image-2.1(第 21)和 Ideogram 4.0(第 22)之后,所以“开放权重文生图第一”的说法在 LMArena 上不成立。Artificial Analysis 已把它的发布日期从 7 月 31 日更正为 11 月 10 日,记录 ID 不变、权重链接指向 HF 官方仓,可以确认就是这次开放的同一个模型。它的许可证与上期逐字节一致,仍是自定义许可、非开源:欧盟、英国、韩国、美国为排除地区,年营收超过 100 万美元需要另行授权。在 AA 文生图榜上,因为新进了 Kling Image 4.0(预览版,第 6)和 Canva Craft(第 10),它从第 23 退到第 25,编辑榜从第 11 退到第 13,分数本身基本没动。
综合榜方面,AA Intelligence Index v5 第一仍是 Claude Fable 5.2(Max)64.6 分,Gemini 4 Carbon 60.0 分第二;AA 自报在 Coding Agent Index v2.1 上 Fable 5.2 与 Opus 5.5 并列 58 分,新版因 FrontierCode 2.0 整体分数下降;AA-Robotics v0.1 上 Fable 5.2 得 75。开放权重第一仍是 Kimi K3.1 Pro 的 46.5 分,其后是 DeepSeek V4.1 Flash 1017(32.6)和 GLM-5.3(31.7)。LMArena 文本榜第一仍是 Gemini 4 Carbon(High),视觉榜本期没有刷新。
Kimi K3.1 Pro 这三天没有官方层面的新事实:moonshotai 官方仓最后一次提交仍是 11 月 5 日,下载量升到约 43,687。变化在周边:HF 上新增 7 个同名仓(6 个是与官方文件哈希一致的全量复制、1 个是空占位),另有 1 个“SuperExpert”复制仓,它复制自上期点名的同类仓库,自标 Apache-2.0 且只有约 12GB,宣称不可信。这些仓本篇不提供入口,下载请认准 moonshotai 官方组织。官方博客仍写“will be released by Nov 4”,是文案滞后,不代表权重未发。
Nex-N2.6 的 OSWorld 83.0 仍然只是 Nex 自报,没有独立复现。唯一能找到的外部测试来自 Plotly(文章日期 11 月 11 日,早于本窗口,上期未收):43 题答对 38 题,与基座 GLM 5.3 Flash 持平,且有两题陷入长时间的工具调用循环,单次完整运行成本 $10.19,基座为 $0.69;Plotly 也说明这是单次运行。
对选型的读者,这一条的用处是校准:图像模型看人类盲测和许可证两栏,大模型看官方仓的提交记录而不是同名镜像的热度,厂商自报的 agent 分数在有独立复现之前只当参考。
深入学习建议
- 选文生图模型时同时看 LMArena 文生图榜与 AA 文生图榜,再读 MiniMax-H3-Image 许可证确认地区与营收限制。
- 下载 Kimi 权重只用 moonshotai 官方仓,并记录文件哈希。
- 读 Plotly 对 Nex-N2.6 的测评,学习它如何报告单次运行与成本。
次要动态
- GPT-6.2 本窗口仍无 OpenAI 官方公告,社交媒体上“本周四发布”的说法无法核实。OpenAI 的 Tibo Sottiaux 在 X 上称此前承诺的额度重置(banked reset)已激活、将陆续到账;ChatGPT 帮助中心的共享额度说明本期未能重新核对。OpenAI 另发布了产品帖 ChatGPT Wallet。
- Claude Code #107757(User-Agent 隐私问题)仍为 open,最后更新于 11 月 13 日 06:57,未见可把 2.1.317 写成已修复的官方说明。Claude Code Desktop 支持用 mods 自定义主题,Projects 协调器也更主动(说明)。
- MAPE(2611.17068,明尼苏达大学与史蒂文斯理工)用程序演化搜索 agent 记忆设计,作者自报在 LoCoMo 与 LongMemEval 上相对人工设计基线准确率最高约 +12 个百分点,serving 成本约为基线的 35%。
- 其他论文备选(数字均为作者自报):Together AI 的持续编译推理(2611.14681)相对手写 Megakernel 最高约 1.7 倍 TPS;成均馆大学的 HeMeR(2611.16487)在实物任务上单步推理从 2.94 秒降到 1.87 秒;百度与北邮的 Folio(2611.16627)在同一 DeepSeek-V4-Pro 骨干下完成 66 题、对照摘要压缩为 54 题;Google DeepMind 等的多元代理参与政策讨论(2611.16028)为 746 人的预注册实验;佐治亚理工与 Google DeepMind 的 Bait(2611.16369)称开放 agentic RL 服务时有害奖励可推翻安全对齐,并给出缓解办法(仅结论,待独立核验)。
- arXiv 覆盖说明:11 月 11 日美国退伍军人节放假,11 月 12 日(Asia/Singapore)没有独立批次,2611.14520–17337 已并入 11 月 13 日批;周末无新批。
- Apple Machine Learning Research 本期窗口内没有新刊登。上期因列表抓取失败漏掉的 4 条在此补录,均非本期新发:KL 正则对齐的理论上界(预印本 2605.07105 为 5 月批,称 best-of-N 接近上界、PPO 与 GRPO 明显次优)、LLM 评委与个性化写作风格、SSM 门控与上下文学习、Weighted State Souping。
- NVIDIA:cuBLAS 的 FP64 新算法称 Ozaki-II DGEMM 相对原生 FP64 在 VR NVL72 / GB200 上约快 5.5 / 3.9 倍;开源 SOMA Retargeter 把人体动作适配到人形机器人;两台 DGX Station 跑 GLM-5.3 教程(检查点约 464 GB)。均为官方自报。
- 新模型(信号较弱):Meta 的 meta-encoder-v1 为 28.4B 多模态嵌入模型,许可未填写,能否商用待核;Liquid AI 的 Liquid-Codec 为 73.6M 流式语音编解码器(自定义许可);KittenTTS 2 Mini 为 82M 参数、只用 CPU 可跑的 Apache-2.0 TTS;蚂蚁 inclusionAI 的 Duo-1.0 基于 MiniMax-H3,沿用其社区许可。
- 窗口前补记(不算本期新发):Edge0-145B-NVFP4 的权重在 11 月 11 日推送,早于本窗口,上期漏收。卡片称单张 24GB 消费卡可跑 145B agent,但小字写明同时需要约 38.27GiB 主机内存;98.3 tok/s 等均为厂商数字,许可为自定义许可,待核。
- 数据集:LlamaIndex 的 ParseBench-2 含 4,317 个页面级文档解析测试(Apache-2.0);Ropedia-Xperience-2 首批 126 个 LiDAR 场景约 1.07TB,非商用许可。
来源与延伸阅读
- Google:Gemini 4 Hydrogen 博文 · DeepMind 同文 · 模型卡 PDF · Search 升级 · Antigravity /teamwork 汇编
- OpenAI:Cyber at the Frontier · Daybreak · Fuzzy Robustness
- Anthropic:IPO 站点 · 安全评测方法文 · Claude Meetings · 自托管 Managed Agents
- SEC:Anthropic 公司页 · 11 月 10 日 S-1/A 索引
- Cursor:安全事件调查更新
- 论文:2611.16069 · Singularity-Bench 2611.16591 · AutoAssumption 2611.14844 · JustRUA 2611.16009 · ZONOS3 报告 2611.16525
- GitHub:llama.cpp v1.0.0 · Codex 0.169.0 · Codex 0.168.0 · deepseek-ai/chat-demo · Transformers v5.23.0
- 模型与榜单:Inkling 2 Small · Thinking Machines 4-bit 训练 · Haru-4B · ZONOS3-Mini · MiniMax-H3-Image · AA 模型榜 · LMArena 文生图榜
- 往期:上期深读(2026-11-12)
今日行动建议
- 用 Gemini 的开发者:拿一组日常编码或 agent 任务,分别用 Hydrogen 的 high 与 xhigh 档和 Carbon 跑一遍,按单任务成本与成功率决定默认档;需要安全证据的场景等完整安全报告发布后再扩量。
- 安全团队:评估 Daybreak 的申请条件与补丁审阅流程,在官方给出可核对评测前不要引用流传的分数。
- 使用 Cursor 的团队:核对 10 月 29 日前后是否装过 Claude Code 扩展 2.1.312 或 2.1.313,按官方通告处置并轮换相关密钥。
- Claude Team 管理员:在 Meetings 默认开启前,确定外宾会议策略和数据保存要求。
- 本地部署者:在分支上验证 llama.cpp v1.0.0 的 API 变化;对外暴露的
llama-server尽快升级。 - 在 CI 中跑
codex exec的团队:升级到 0.169 后检查脚本行为,只对可信目录加--trust。 - 研究训练效率的读者:精读 Thinking Machines 的 4-bit 配方,复算 CE 代价与墙钟收益的关系。
- 写行业分析的读者:IPO 稿件把发行条款、公司自报财务和媒体估值分开写,以 424B 或正式定价公告为准。