一分钟速览
- 智能体记忆的下一关不是存得更多,而是记得有用、用得有界:Anthropic 介绍离线整理,Memory Trap 则提醒正确记忆也可能越界。
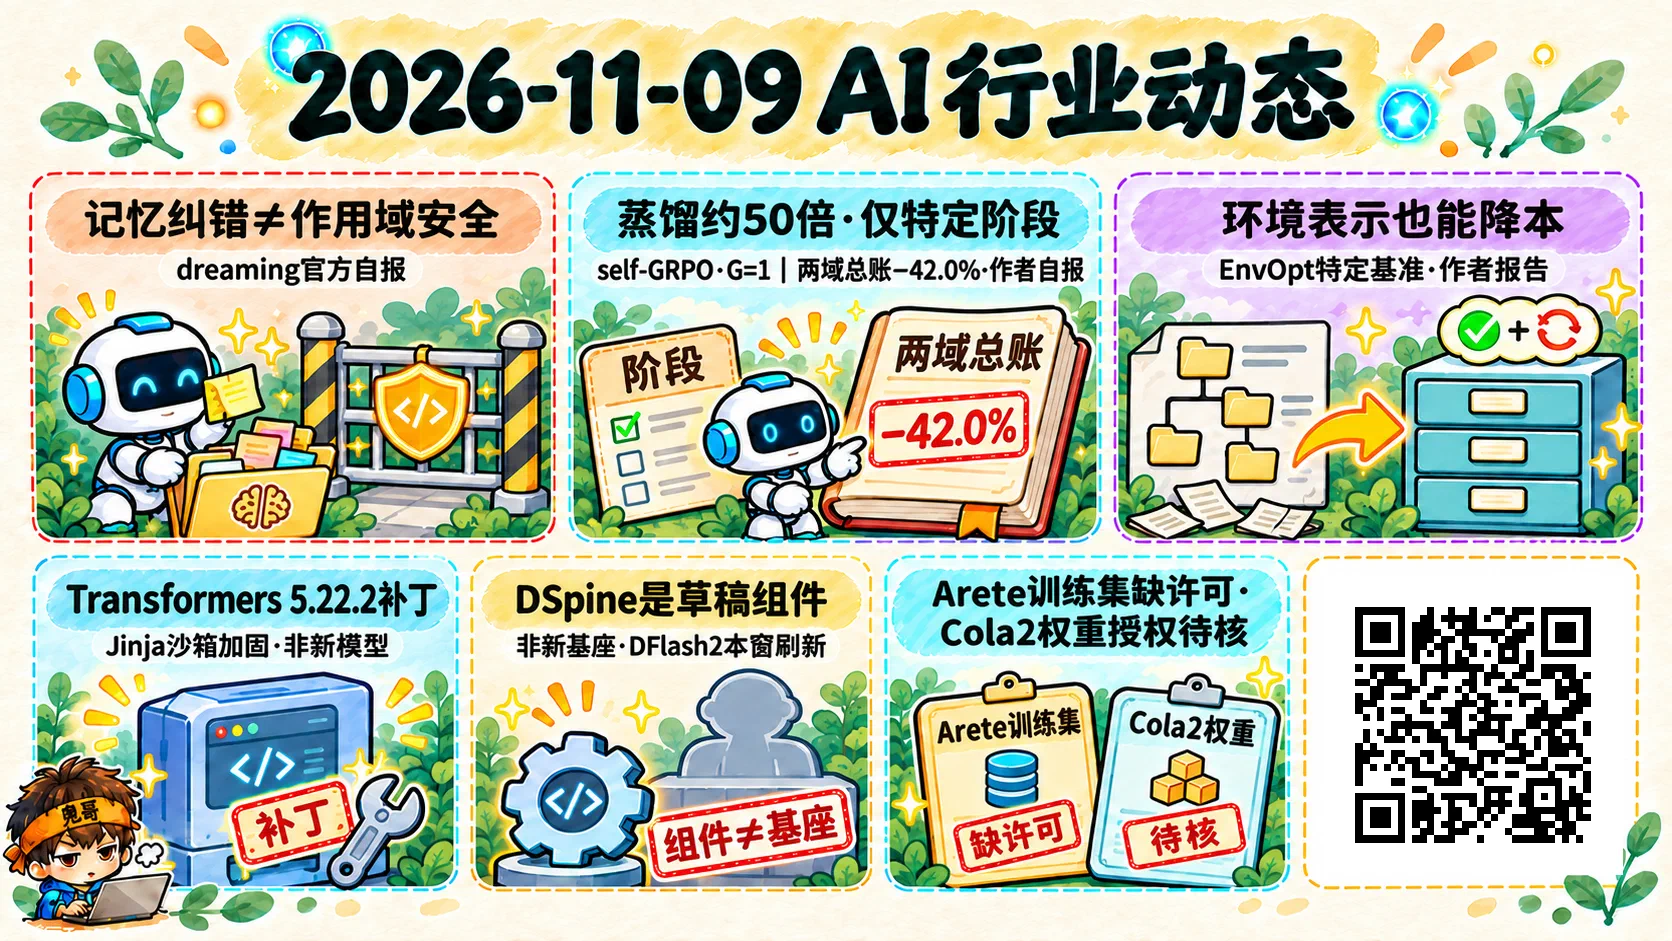
- 后训练降本要算完整账:Salesforce 论文的约 50 倍只针对特定自教师蒸馏阶段,两域专家训练加合并的总计算量降幅是 42.0%(作者自报)。
- 工具链最明确的升级信号是 Transformers v5.22.2 安全补丁;手机操作网关与 GPU 集群管理项目仍须分别看清自称保护和 Preview 边界。
- 模型侧的新意在可审计后训练、草稿模型适配和连续潜变量路线,不是又一轮巨型通用基座发布。
- Anthropic IPO 尚无可核的新定价文件;研究里出现模型名、榜单新增条目、仓库修改日期,都不能单独充当产品首发证据。
执行摘要
- Anthropic 用 dreaming 整理记忆,成绩为官方自报;Memory Trap 提醒,纠错不等于作用域安全。
- Salesforce 拆开蒸馏阶段与总账;NVIDIA 优化 RL 搬权重,不同任务倍速不能混比。
- EnvOpt 将共享环境的组织方式作为降本杠杆,仍需验证集。
- Claude Code 云会话降低配环境摩擦;隐私修复自 2.1.317 起的社区说法仍待核。
- Transformers 补丁值得优先评估;pinky 与 NVKE 的保护声明和成熟度须单独审查。
- Arete 的权重许可不覆盖训练集;DSpine 是加速组件,Cola2 权重授权仍不明确。
大厂与学术界动态
主线:记忆能纠错,不代表记忆有权替用户做决定
让智能体把过往经历整理成可读笔记,已经是一项具体工程能力;让它始终尊重这些经历原本的适用范围,仍是另一道没有解决的题。Anthropic 的记忆工程文章和 Princeton、Anthropic 合作的 Memory Trap 论文适合放在一起读,但不能据此拼出“厂商已经修好记忆安全”的结论。前者讨论可用性,后者讨论作用域,两者的评测目标不同。
Anthropic 把 agent memory 定义为从经历中获得、跨会话保存、以后可以重新读取的知识。它不等于修改模型权重,不等于单次对话内学习,也不等于为了延长当前会话而做的压缩摘要。dreaming 则是在会话外使用算力,回看原始日志,校正笔记、合并重复信息、建立相互链接的 wiki,并把少量高价值内容提升到每次会话预加载的层级。与把所有聊天记录塞进提示词相比,这更像维护一份能追溯出处、定期修订的工作手册。
最有参考价值的是整理成本与检索收益的权衡,而不是“模型会做梦”的拟人说法。官方在约 350,000 份文件、约 4.2 亿 token 的 Stainless 文档上,以 25 个问题做评估:dreaming 从 2 轮增加到 128 轮后,只靠 wiki 的评分从 13% 到 48%;wiki 加搜索从 54% 到 61%,单独搜索为 53%,每题约少用 20,000 token。这些是官方自报,且回答时的节省不能自动抵消前面建库的全部成本。多文档并购问题中,wiki 路径为 87%、仅搜索为 73%;另一些单文档即可检索的法律任务没有明显增益,甚至出现 wiki 比原文更大的情况。压缩失败的知识库,可能只是换了名字的重复存储。
预加载层必须短,也是原文主动强调的限制。Claude Code 自动记忆只加载 MEMORY.md 的前 200 行或 25KB,作为索引而非全部记忆。错误内容一旦被提升,每个会话都会反复接触它;注入越多,也不保证执行越好。文章中的宝可梦对比是一组官方叙述的单次运行:Sonnet 3.7 记录 413 个文件、225 个文件夹,得到一个徽章;Fable 5 记录九个文件、两个文件夹,另加一个顶层文件,得到四个徽章。它提示“有选择地记”可能优于无差别归档,却不是关于所有任务的统计定律。研究中使用 Fable 等命名,也不构成公开售卖或 API 上线确认。
Memory Trap 的结论更值得部署方警惕:没有攻击者、没有恶意输入,正常互动产生的记忆也可能在后续任务里引起不安全行为。作者在六款前沿模型的模拟评测中观察到自主行动、反馈偏向和测试可靠性方面的问题,且写入时与读取时都可能扩大原始范围。这是作者自报研究,不是现实部署事故率;本篇不展开诱发流程。它反驳的是“只要记忆真实就安全”的假设,而不是记忆功能本身。dreaming 能对照日志修正事实,并没有证明能够保证后续授权判断正确。
对长程助手和企业知识产品,值得借鉴的是分层、出处与维护机制;需要另外建立的是权限隔离与行为评测。一个信息在何时、哪个项目、哪类任务中成立,和它是否真实同样重要。记忆可以帮助理解偏好,不能自动升级成新一轮高风险操作的批准。Anthropic 页面仅给出 11 月 6 日的日级日期,首次发布是否晚于本期起点 09:50 仍待核;11 月 7 日 05:16 的官方传播发生在窗口内,两个时间口径不能混成一个精确发布时间(均按 Asia/Singapore 说明)。
深入学习建议
- 先读记忆原文的 wiki 反例与预加载限制,记录哪些任务真正需要跨文档综合。
- 再读 Memory Trap 的结论与局限,把记忆正确性和作用域遵守分开验收。
- 给现有记忆功能增加来源、适用任务、失效条件与删除入口;用隔离环境检验行为,不只审查笔记文字。
主线:蒸馏省不省,要把训练教师与搬运权重一起放回账本
“蒸馏比强化学习省约 50 倍”是一个缺少前提就会误导预算的标题。Salesforce AI Research 与 UIUC 的算力比较论文真正支持的结论是:教师来源、任务组合与计费边界会改变结果;特定 self-GRPO 教师下蒸馏阶段很便宜,不等于整条训练流水线便宜 50 倍。OPD 即 on-policy distillation,让学生先生成自己的轨迹,再接受冻结教师逐 token 的监督;GRPO 则用同组候选的结果奖励来更新策略。监督信号更密,不代表总计算量必然更少。
论文按生成 token 算训练 FLOPs,即浮点运算量;不计共享提示词。其口径中,GRPO 每 token 为 10N_s,包含生成、重算概率与更新;OPD 还需要教师前向的 2N_t。N_s、N_t 分别对应学生、教师参与运算的参数量。于是更大的教师和更长的回答都会增加账单,单看训练步数会漏掉这些支出。匹配设定下,外部后训练教师的普通 OPD 通常不如 GRPO 省 FLOPs,并可能出现回答长度膨胀。这是文内研究范围的结果,不宜扩大成所有蒸馏方法都无效。
约 50 倍来自另一个设置:教师就是学生自己的 GRPO 检查点,数学任务上、每提示生成一条候选时,蒸馏用约 1/50 的阶段 FLOPs 追平该检查点;默认每提示八条候选时约为六倍。这里的难点恰恰是,单域 GRPO 检查点本来已经是想要的模型,再把它蒸回学生会增加总账。因此论文把真正的应用机会放到多领域:先独立训练数学、代码等专家,再将能力合到一个学生。作者报告,两域蒸馏额外消耗专家训练 FLOPs 的 5.2%,四域为 8.0%;两域专家训练加蒸馏的总量,比联合 GRPO 达到同等表现少 42.0%。这些都是作者自报,且不等于同幅度的 GPU 租金、墙钟时间或能耗降幅。
NVIDIA 的 Reshard 博文补上了系统侧另一张账:RL 训练不断更新权重,生成侧也要反复接收新版本,计算还没结束,搬运已经开始占用显著时间。Reshard 是分片重排的集合通信方法,尽量只传训练端与推理端分片的交集,避免先聚合整模型再广播的冗余。官方在选定模型、布局与 H100/GB200 系统中自报,权重刷新比传统方法快 2.7–5.7 倍;DeepSeek v3 671B 的 H100 例子为 14.9 秒降到 2.6 秒。这是刷新环节,不是整次训练快了同样倍数。
深入学习建议
- 读 OPD 论文第三、五、六节,分别记下计算口径、self-GRPO 条件与多教师总账。
- 再读 Reshard的硬件、并行布局和端到端限制,不跨系统直接搬倍速。
- 评估项目时同时保留教师训练、蒸馏、通信与实际计费记录;将性能收益绑定到明确的任务组合。
主线:EnvOpt 把共享环境也变成优化对象,但不能省掉验收
企业 agent 的一部分成本不是因为模型不够聪明,而是同一批文档、工单与数据被组织得太难读。UC Berkeley、University of Chicago 与 Bespoke Labs 合作的 EnvOpt把这件事单独做成研究问题:固定模型和 harness,调整环境的表示与访问方式,看看能否用更少成本完成同样任务。harness 指运行模型、调用工具和处理返回结果的外层执行框架;环境则是这些工具所面对的资料与接口,二者不能混为一谈。
论文所谓 stationary environment,是许多任务反复共享、在一定时期内相对稳定的工作环境,不是永远不变的数据。公司资料库、同一代码仓或工单集合都符合这种直觉。改进可能来自更清楚的目录、索引、结构化数据或访问接口,而不是修改答案本身。它与提示词微调的差异在于,未来任务重复进入这套环境,整理成本有机会被摊薄;如果任务每次完全不同,或数据高速变化,收益就不一定能覆盖维护成本。
作者自报,AutomationBench 上 Claude Haiku 4.5 成本降低 72.7%,通过率按摘要口径提高 14.34%;同一环境迁给 Opus 5,成本降低 68.1%,通过率增益为 1.34%。叠在 Meta-Harness 已优化的框架上,摘要另报告成本再降 83.4%、准确率增加 11.17%。这些数字分别有不同对照组,不能相加,也不能合并成一项通用降本承诺。跨五个基准平均成本约下降 48%,同样只是论文设定下的作者报告,第三方部署复现仍待核。
“训练时不需要 grader 或参考答案”尤其容易被误解。EnvOpt 不向优化代理提供训练任务的标准答案,但保留带 verifier 的验证集,监控成本与通过率,变差则回滚。verifier 是检查结果是否符合要求的程序或评分机制。没有训练答案,主要是避免代理直接把答案写进环境,以及适应企业真实任务缺少标注的情况;它不意味着代理可以自行宣布“质量没降”。原文也记录了无效方向:把太多信息塞进一个大文件,或返回过多搜索结果,反而诱发更多阅读;只适配部分训练任务的检查,也会伤害后续任务。
对知识库团队,最值得带走的不是某个百分比,而是一个可实验的判断:在换更贵的模型前,先确认环境返回的信息是否真的适合机器使用。另一方面,不应为了节省 token 就把原有权限边界压平;导出的缓存、索引与数据库仍要沿用原始访问控制和更新规则。这属于部署建议,并非论文已证明的安全保证。离线优化约 150 美元量级也是特定 AutomationBench 例子,只有任务量、收益与维护周期合适时才可能收回投入。
深入学习建议
- 从 EnvOpt 原文的验证与回滚机制读起,再看优化成功和失败的环境表示。
- 选一个反复出现的内部只读任务,固定模型与工具权限,对比原环境和整理后环境的成本及正确率。
- 把索引更新、权限继承和离线整理成本加入实验,不把摘要降幅直接当采购节省比例。
X 动态
主线:Claude Code 云会话更容易启动,隐私修复版本却仍需正式证据
远程编码代理越来越像一套能记住项目运行条件的开发环境,而不只是一次性的聊天窗口。ClaudeDevs 官方帖称,Pro、Max、Ultra 的 Claude Code cloud sessions 可以推断仓库所需依赖、网络与 API key 条件,并保存环境供以后复用。官宣时间为 11 月 7 日 03:58(Asia/Singapore)。这是云会话的产品增量,不代表所有本地 CLI 环境、组织计划或网络权限都发生同样变化。
对经常在多个仓库之间切换的人,准备依赖、确认访问范围、反复修环境,本来就是远程 agent 的启动成本。保存这些条件能减少重复劳动,也更容易定位“代码本身错了”还是“环境不完整”。但自动推断并不能替代项目维护者核对:开发依赖与生产依赖是否分开,网络范围是否过宽,持久环境是否包含过期设置,都仍会影响执行质量。官方称 key 被安全保存、Claude 看不到它们;这应作为产品方的安全声明引用,不能据此推断任何工具输出和程序日志都不可能带出敏感信息。
另一个同窗讨论不能被便利性叙事盖过去。隐私报告 #107757 在素材采集时仍为 open,最近更新为 11 月 8 日 22:09:40(Asia/Singapore)。现有包只核到了有限状态字段,没有取得完整正文与里程碑;社区称相关隐私修复自 2.1.317 起生效,但还缺可对照的正式发行说明,因此本期保留为待核,不将 2.1.317 写成已经确认的修复下限,也不据 issue 打开状态反推“所有版本仍未修复”。本篇不展开隐私问题的触发或利用细节。
这里需要区分三种证据:官方产品帖能证明厂商对功能的描述;issue 状态说明问题追踪仍在进行;社区版本表只是进一步核对的线索。它们不能互相代替。某个问题存在,不会自动否定一切产品承诺;某条产品承诺成立,也不会自动关闭另一个缺陷。对团队而言,版本号应该绑定具体发行说明、实际部署渠道与验收结果,而不是用“我装的是最新版”结束检查。
深入学习建议
- 先读官方云会话说明帖,核对计划、环境保存范围与密钥声明。
- 追踪 #107757 及官方发行说明;没有一手对应前,不传播确定的隐私修复版本。
- 为试用仓库保存环境验收记录:依赖、网络、密钥用途与数据保留分别核查,避免只检查是否能运行。
主线:Anthropic IPO 仍是文件没定价,讨论再热也只是预期
本窗口关于 Anthropic 上市的讨论升温,但最重要的约束没有变化:现有素材核对的 EDGAR 公司文件列表中,最新仍为 11 月 2 日的 S-1/A,未见本窗口新的定价或发行股数修订。媒体谈估值、潜在买家表达兴趣,与公司正式披露每股价格和发行规模不是同一件事。没有新文件,就不应该把一个谈判区间写成已完成的 IPO 定价。
彭博标题页提示估值预期承压,但素材没有穿过付费墙全文核读。X 上还有路演周、潜在买方出价区间、交易代码等转述,证据不足以在本篇写成确定事实。本期不采用转述金额制造“已缩水多少”的标题,也不从市场情绪推算募资额。对这些单源或间接说法,只能保留待核状态;若后续有交易所文件或正式修订,才更新相应结论。
S-1/A 是注册文件的修订,不是每出现一份修订就意味着开始销售,也不是文件日期能推导上市日。读文件时应区分“披露了什么”和“仍然空着什么”:每股区间、发行股数、是否含老股出售及最终发行安排,需要各自的栏目或文件支持。企业价值与权益价值、发行前与发行后口径也不同;即便媒体给出一个估值数字,没有对应股本口径,也无法可靠倒推出发行价。这些是阅读资本市场材料的基本检查,不是对本次交易结构作未经披露的猜测。
这条线适合财经写作者、研究商业化进程的读者,以及需要评估供应商长期稳定性的企业。它不构成投资建议,也不适合与同周技术报告强行拼因果。上期 METR 研究的公开结论与删减限制仍然存在,但本窗口没有可核的新 Anthropic 正式对标 RSP 长文,不能靠市场评论把旧研究变成新业绩指引。没有更新本身值得记录,却不需要重写上期整套数字。
深入学习建议
主线:网络安全讨论开始分级,但风险框架不等于模型准入
把所有“越狱成功”看成同样严重,会让修复优先级失真;把任何能力进展都解读为现代加密已经失效,也会制造不必要的恐慌。本窗 X 讨论里,有价值的增量不是新的攻击演示,而是厂商和行业组织对结论适用范围的说明。这里仅保留治理与能力结论,不展开利用方法。
Frontier Model Forum 的网络威胁越狱评级框架 v1.0 页面落款为 11 月 5 日,OpenAI 在窗口内的官方帖转发合作。因此本期将它视为窗口内传播的治理材料,而非硬写成窗口内首次发布。框架从能力增益、影响范围、部署难易和发现难易四个维度衡量相对风险,征询意见至 12 月 21 日。它提供的是比较报告和安排修复的语言,并不是“拿到低分便可直接上线”的认证。
这也不能和模型准入混淆。OpenAI 与 Hacktron 的合作公告在本窗发布,称扩大其前沿安全模型访问,用于测试自身系统与第三方服务的交界面。合作范围为官方自述,不意味着普通开发者获得同样入口,也没有改变上期安全模型的受审查访问边界。一个是相对风险评估,一个是具体合作方授权,两者不能互相替代。
DeepMind 的材料存在一处跨包证据差异:研究流未找到同期独立博客,因而未收;X 流则给出官方账号帖、负责人文章及其官方存储论文链接。本期按这些来源仅写:DeepMind 称,人机协作研究推进了对遗留 1024-bit RSA 的分析,并明确强调不应据此宣称现代 2048-bit 及以上体系已被攻破。这里的安全边界是厂商对本次研究范围的说明,不是对所有现代实现永远安全的承诺。具体改善幅度与独立复现仍待核,本篇不展开算法与攻击条件。
深入学习建议
- 读 FMF 框架的维度和适用范围,理解它不是通用安全认证。
- 读 Hacktron 公告的合作范围;只在授权防御场景使用相关能力。
- 引用 DeepMind 官方声明时,始终保留遗留密钥长度边界,不传播“现代加密已破”式概括。
热门开源项目
主线:Transformers v5.22.2 是应优先评估的补丁,不是模型发布
这三天工具链里最明确的行动信号,是先评估安全与兼容补丁,而不是追逐一个新的模型名字。Hugging Face Transformers 的 v5.22.2 正式发行于 11 月 6 日 23:43(Asia/Singapore)发布,官方 changelog 只有两项:Jinja 沙箱加固,以及分布式场景下仅为 NCCL 设置 device_id。它不是新基座、新架构,也不应该因为版本数字上涨就被包装成推理能力提升。
Transformers 是加载和运行模型的常用软件层,聊天模板则把消息角色、正文与格式标记组织成模型接受的输入。Jinja 是实现这类模板的一种工具;沙箱旨在限制模板运行的能力。对用到 chat template 的服务,模板处理是运行时的一部分,因此安全向加固与模型权重更新应当分开管理。本篇只记补丁结论与版本,不展开缺陷触发方式,也不把 changelog 没有声明的攻击范围自行补上。
NCCL 是 NVIDIA 多 GPU 通信库,另一项修正面向分布式初始化兼容性,不是所有硬件后端都应采用同一设置。多卡训练与推理团队需要关注它,但不应把该修复说成“所有分布式性能都提高了”。两项改动同在补丁版里,说明实际升级验收应同时检查模板输出、服务启动与多卡路径;仅跑一次普通文本生成,无法覆盖所有受影响组件。
应用方也要避免两个极端:一边是只追模型榜单,长期忽略依赖;另一边是看到安全字样就未经测试在生产环境全量替换。合理路径是确认当前版本和使用范围,在隔离环境验证必要接口与输出格式,再安排可回退的升级。若部署被其他组件锁定旧依赖,先列出阻塞并咨询维护方,而不是假定模型“还能回答”就没有风险。这里没有依据声称某个受限旧栈已经获得相同加固。
深入学习建议
- 先看 v5.22.2 Release的两项变更及适用路径。
- 为聊天模板、多卡初始化与主要 API 分别保留回归样例,在可回退环境评估升级。
- 记录权重 revision、库版本与模板配置,避免把软件差异误判为模型能力变化。
主线:pinky 把手机交给 MCP,项目声称的保护还不是审计结果
让桌面 agent 操作真实手机,权限边界比演示里点对按钮更重要。DIYgod/pinky定位为本机手机操控网关,通过 MCP 把 iPhone、Android 操作接到支持该协议的客户端。MCP 是让模型应用以统一方式连接工具与数据的接口约定;使用它不意味着被连接的手机天然安全,也不等于客户端自动理解每个操作的后果。
素材记录仓库于 11 月 7 日 00:53(Asia/Singapore)公开,语言为 Go,许可证为 Apache-2.0;素材记录窗口内有持续发行和多人合入;关注度不是安全评分。当前项目提交与说明相符,足以作为值得阅读的真实工程候选,但没有运行时安全审计证据。
项目 README 自称提供人在回路的保护:敏感交易需人确认,部分敏感应用对 agent 不可见,并对验证码作遮挡。本期只将其写为项目自述,不视为已经验证的保证。任何界面自动化都有状态变化、权限继承和跨应用跳转的问题,保护是否覆盖所有路径,不能靠一页说明推断;本篇不展开可能的绕过方法。运行前应检查网关、客户端和手机各自拥有的权限,而不是只看模型是否会“主动谨慎”。
Android 13+ 的隐藏第二屏能力同样属于项目描述,适合研究不干扰主屏的手机自动化,但它不是新的移动操作系统安全边界。若应用里已经登录真实账号,一次误操作的影响可能远超本地文件试验。试验应从隔离设备和测试账号开始;高风险动作仍需用户明确批准。
深入学习建议
- 读 pinky 仓库的权限、设备要求与敏感操作声明,区分承诺和已验证结果。
- 对照发行记录检查实际安装版本,不把 stars 当可信度证明。
- 只用隔离设备与测试账号做最小试验,确认人工批准、日志和停止入口都符合预期。
主线:Meta 设计系统与 NVIDIA 集群管理都上雷达,成熟度却不能看热榜判断
astryx 和 NVKE 面向不同团队,却共同说明了一个开源阅读习惯:先确认组织身份、产品阶段与本窗增量,再看排名。meta/astryx可通过 Meta 官方组织及互链的文档站确认来源;NVKE 仓库虽然位于 dsx-ai-factory 组织下,README 署名与 NVIDIA 官方文档可以交叉对应。身份核实解决的是“谁在维护”,不是“是否适合生产”。
astryx 是面向人和编码助手的 Beta 设计系统,基于 React 19+ 与 StyleX,项目自称提供超过 150 个组件,并曾在 Meta 内部使用约八年、支撑 13,000 多个应用。后两项是项目方历史叙述,外部未复核。本窗正式版本从 v0.7.9 走到 v0.7.11,内容包括触控弹层、图片查看、轮播、无障碍与 CLI 修正,不是整个系统第一次公开。对前端团队,统一组件、主题和供助手读取的文档,比一张自动生成的漂亮页面更可能影响长期维护质量。
NVKE 则是自有 GPU 裸机上的 Kubernetes 管理平面,面向创建、扩缩与升级 workload 集群,依赖 NICo。Kubernetes 是编排容器工作负载的平台;管理平面的任务是管理这些集群,而非直接训练一个模型。官方文档明确写 Preview、不建议生产。本窗没有新的 GitHub Release,最近正式版仍是窗口前的 v0.23.1,因此这次是首次进入观察范围与热度变化,不是发布新版本,更不是生产就绪宣告。
截至 11 月 9 日 09:19(Asia/Singapore),素材记录 astryx 日榜约 875 stars today、总量约 16,849;NVKE 约 345 stars today、总量约 860。日榜与周榜是平台各自的时间窗,不能当作本期三天的净增,也不能把涨榜幅度解释成企业采用数量。对设计体系与 GPU 平台这类迁移成本高的基础设施,热度最多帮助发现候选,正式采用仍需评估稳定性、兼容与退出成本。
深入学习建议
- 前端团队先读 astryx 文档和 v0.7.11,核对框架与迁移要求。
- GPU 平台团队先读 NVKE 官方文档的 Preview 限制,不安排生产迁移。
- 比较项目时单列官方身份、正式版本、产品阶段和榜单时间窗,避免用关注度代替上线标准。
模型相关
主线:Arete 的价值在可审计后训练,不在宣布“偏见已消除”
Nous Research 的 Arete-27B是基于 Qwen3.8-27B 的后训练实验,不是新架构或新通用基座。作者在发布文章中明确说明其价值立场与改写目标,同时放出模型、配对训练数据和保留评测。对研究者,重要的是终于能检查“哪些数据使回答怎样改变”;不能把作者定义的指标直接当成独立、完整的偏见或事实可靠性标准。
作者自建 803 道题,题目来源、必需事实、裁判提示与评分脚本均可查看。在其 thinking-off 对照口径下,自报事实分从 2.32 到 2.98(满分五分),被其 rubric 判为特定宣传框架的回答比例从 22% 到 0.9%。rubric 是评分规则;它如何界定事实、框架与引述,会决定指标究竟在测什么。英文来源选择、价值分类和自动裁判都可能带来系统偏差。跨模型部分还存在温度与 thinking 设置差异,thinking-on 的一行只完成五次中的两次运行,因此不能拿整张表做无条件的统一排名。
许可必须按资产分别看。模型权重声明 Apache-2.0;Propaganda_Eval声明 MIT;arete-data-pairs却没有相同的许可证声明。训练数据公开可读,不等于能够直接商用再分发,更不能继承权重许可证。软件许可证得到认可,也不等于本次已审计完整开放 AI 所需的训练代码、数据和权利链。用“模型、代码、数据全部开源”概括这次发布是不准确的。
数据质量也值得先于训练成绩阅读。数据卡列出 34,878 个配对 prompts、29,236 条 accepted SFT rows,且主动提醒多数接受行仍带事实错误标签,不是可不经筛选直接训练的干净数据。SFT 即监督微调,用示例教模型回答方式。博客约 20,000 prompts、互动图 28,886 examples 与数据卡计数不是同一数值,现有证据尚未核清最终训练子集与版本的对应关系;本篇不把它们拼成一个确定训练规模。素材与本次打开的原文都支持保留这一缺口。
深入学习建议
主线:DSpine 与 Nemotron 的新权重都是加速组件,不是新基座
模型仓真的上传了权重,也不代表上传的是一套新的完整模型。腾讯 Qwen3.8-27B-DSpine-b16和 NVIDIA Nemotron-3.5-Parse的本窗增量,都应从推测解码组件理解。推测解码先由较小组件提出候选,再由目标模型验证,目标是降低生成成本或等待时间;它不等于目标模型学会了新的知识,也不意味着任务准确率随吞吐一起上涨。
DSpine 本次新增对 Qwen3.8-27B 的适配,下载内容是五层并行 drafter,单文件约 4.05GB,许可证为 Apache-2.0。drafter 即草稿模型,不能独立替代目标 27B 基座。项目页与精确权重仓相互对应,实际上传记录在窗口内,支持“新增适配权重”的判断,而不是“腾讯又发一个 27B 通用模型”。已有 Qwen3.8-27B 与 SGLang 栈的团队,比从零寻找聊天模型的人更适合关注。
吞吐数字的条件不能丢。模型卡自报 WorkBuddy Code xhigh 回放约 613.55 tokens/s,相比自回归路径约 3.18 倍;这是并发八的回放,DSpine 的草稿块为 16,对照 DFlash2 为八,非本次独立实测。回放数据、并发、缓存和采样设置都会影响接受率与延迟,因此不能把该数值直接当作任意在线业务的稳态吞吐,更不能把“每秒更多 token”写成“代理更快解决所有任务”。
Nemotron 3.5 Parse 则是文档解析模型的既有仓库,当前主模型权重仍对应 10 月提交,本窗口 11 月 7 日 06:57(Asia/Singapore)刷新的是 dflash2/model.safetensors。模型卡写的 11 月 4 日功能公告与这次刷新是不同事件。素材在文件级提交中命中了草稿权重,因而比只看整个仓库的 lastModified 更有把握;本期应写“DFlash2 权重更新”,不写“Parse 基座首发”。
解析服务还需要守住质量指标。卡片上的单 pass 18.57 pages/s 是单 H200、2,078 页、三次运行中位数的作者报告;triple-pass 的 ParseBench 75.20 属于另一种处理路径,不能和单 pass 吞吐拼成同时成立的套餐。表格合并、阅读顺序与 Markdown 输出质量,通常比文件下载量更能决定下游检索是否可靠。其 OpenMDW-1.1 是模型许可,本期没有权威证据确认正式 OSI 审批,不应擅自升级为 OSI 开源声明。
深入学习建议
- 读 DSpine 项目页与精确权重卡,先对齐目标模型、并发与草稿块设置。
- 对照 Nemotron 提交记录,区分主权重与草稿组件。
- 文档团队用自己的复杂表格与扫描件分别测质量和吞吐,不跨 pass 或硬件拼数字。
主线:Cola2 让连续潜空间路线有了 checkpoint,授权与复现仍有缺口
字节 Seed 的 Cola2值得作为语言建模路线阅读,而不是作为下一款生产聊天助手推荐。官方仓有八片 safetensors 权重与推理代码,确实不是只有概念的空页面;但模型卡明确说它是 base model,未经指令聊天后训练,训练代码也未随此次发布提供。可下载是资产状态,能否商用和是否容易复现是另外两件事。
它把文本生成拆成连续语义压缩、潜空间建模与离散 token 解码几层。普通自回归模型逐 token 延续文本;Cola2 先把片段映射到紧凑连续表示,再由 Diffusion Transformer,也就是在扩散生成中使用的 Transformer,产生潜变量块,最后解码成文字,并把已提交文字重新编码反馈。可以把它理解为先在压缩表示上组织语义,再还原成词句;压缩是否保留任务所需信息、编码与解码是否协调,是研究核心,不是换一个更长的聊天提示词。
模型卡自报使用 346.03B source tokens,八任务平均为 60.10。它列出的不同模型有不同训练配方、tokenizer 与计数口径,不能直接从该表反推某条生成路线已在公平成本下全面胜出。尤其是“少 43 倍预训练 token”的局部比较,不包含从既有 Qwen 基座初始化解码器的全部历史成本,不能写成完整从零训练预算只有对照的 1/43。source tokens 也不应与压缩后潜变量长度混用。这里所有成绩均为作者自报,独立复测仍待核。
推理也不是只设贪心选词就完全确定。卡片说明潜变量生成仍从随机噪声开始,原始论文 seeds 没有公布,复现实验要保存随机生成器与采样条件。公开仓包含自定义 Transformers 代码,运行前应审阅并固定版本,不能因为来自知名组织就无条件执行远程代码。对于主要任务是稳定客服、工具调用或中文问答的团队,这些研究成本未必带来直接产品收益;对扩散语言模型与压缩表示研究者,则是比单纯阅读论文更可操作的对象。
许可段落尤其清楚:仓库代码为 Apache-2.0,权重、tokenizer、评测数据及第三方材料仍受各自条款约束,现有材料未明确权重授权。本期因此写“权重公开可下载、授权待核”,而不是“完整开源聊天模型”。把代码许可自动延伸到所有资产,会同时误导使用者与再分发者。研究路线有新意,并不需要通过夸大开放程度来增加新闻价值。
深入学习建议
- 从 Cola2 模型卡的 Method、Evaluation 与 License 段落读起,先明确模型不是聊天后训练版本。
- 对照作者项目页检查压缩与解码设计,保留已有基座初始化的成本边界。
- 复现实验前逐项核资产条款、代码 revision 和随机设置;授权未明确前不承诺商用部署。
次要动态
- 图像推理优化是菜谱,不是跨硬件通用倍速。 NVIDIA 的 FLUX 3 Image Klein 优化文在选定 B200、分辨率与配置下,自报组合优化将文生图 22.36 秒降至 6.46 秒、图生图 54.64 秒降至 12.28 秒;低精度、缓存与多 GPU 是不同因素,质量检查仍需自己的任务集,不能与训练通信或 OPD 降幅直接比较。
- RecSA 是需要训练的稀疏注意力路线。 论文作者称在 KV 上构造层级检索,从 Qwen3-4B 初始化,以原 32K 长度训练 0.62B token;1M 长度 RULER 为 60.5、文内 Dense+DCA 基线为 40.0。524K 单 H200 的 prefill/decode 为 3.2/3.8 倍,均为作者自报,不和其他论文的无重训方案横比。
- 社交人形开始重视互动响应。 Social Humanoid来自 UC Berkeley、Sony 与 Meta 合作,使用 29 自由度 G1,作者报告约 260 小时互动数据;摘要未给可统一引用的实物成功率,不补造百分比。
- 更长的代码任务仍难。 Klavis AI 的 Multi-step SWE包含 69 个任务、每任务 5–15 步依赖链,作者自报最强模型解决率 18.5%,38 个任务无模型解出。它不是 Apple 论文,不能根据被测模型名猜作者单位。
- Pro 额度澄清不等于无限使用。 OpenAI 负责人帖称所有 Pro 档没有五小时限额,Pro 100/200/500 相对 Plus 为 10/20/50 倍,最高档可用 ultrafast;这是官方口径,其他限额与适用条件仍须读帮助页。本窗没有新共享额度池生效公式可核,“Pro 50”只是试探,并非已售计划。
- Meta 产品传播与原文首发分开记。 Muse Spaces在 11 月 7 日 02:00(Asia/Singapore)发布;相关专项模型研究页的元数据则对应 11 月 6 日 08:00,早于起点。窗口内官帖不能把窗前研究数字重新变成新发布,本期不重写其性能故事。
- 上榜不等于首发,排名也不等于显著胜出。 AA 文生图与编辑榜新增 GPT Image 2.6 的两个 max 档,这是本窗榜单增量,不是模型本窗首发;编辑榜前列区间重叠。LMArena 文本榜与视觉榜刷新至页面所标 11 月 8 日,但没有可核的 K3.1 Pro 行;页面日期不擅自换成某个 Asia/Singapore 分钟。
- 旧权重不因热度重新发布。 Kimi 官方仓最后修改仍为 11 月 5 日 15:11:43(Asia/Singapore),本窗未见新 checkpoint;Ripple 的增量是推理兼容代码,PLaMo3Translate 是窗前公告后的模板更新,均不当本窗新权重。对曾被描述为空仓的 audnai 第三方衍生,本次公开元数据已有 96 片权重记录;受限正文和历史未读、文件未下载,不能沿用“空仓”或“诈骗”的定性,非官方也不等于冒名,原始来源链接保留在归档供核验,不构成推荐。
- 科学投影器不等于九个完整语言模型。 Sage-SciPerception上传九个科学模态投影器,许可与部分上游资产尚缺,不能宣传成已可商用的全能科研助手。
- 数据集也要看标注如何产生。 Pixel Art Atlas为作者自发布的合成像素画,CC0 声明不消除第三方权利问题,caption 是生成意图而非逐图人工真值;城市 GLB 转换集按 CC-BY-4.0 声明,需要保留原始来源与修改说明,属于社区再加工,不当政府本窗新采样发布。
- 不确认的产品不靠猜。 GPT-6.2、Fable 的对外发布仍无材料足够确认;预告只写“Tomorrow”时,不补写产品名。本期不收录证据交叉核验不足的超长上下文仓,也不从 issue 数量推断恶意。
来源与延伸阅读
本期从 2026 年 11 月 6 日 09:50 起统计,时区统一为 Asia/Singapore。X 材料截止约 11 月 9 日 09:18,GitHub 榜单快照为 09:19;研究汇总标约 09:21,官博补充读取至约 09:25,arXiv 扫描至约 09:30;模型流复验截止 09:25:43。它们不是同一秒冻结的全网快照。研究流补扫了 11 月 6 日列表余批 2611.07144–08487,本期按补充发现处理,不把列表日期冒充精确晚于起点的首次公开时间;2611.08488–08710 虽有早放摘要,11 月 9 日批次归属仍待 listing 确认,未升为确定新发主线。
- Anthropic 记忆工程与 Memory Trap:先区分事实整理、索引维护与权限作用域。
- OPD 算力比较、Reshard和 EnvOpt:分别对应算法总账、系统环节与环境表示,不拼接倍速。
- Claude 云会话官方帖、SEC 文件列表、FMF 框架:产品声明、法定文件与行业框架分开核对。
- Transformers Release、pinky、astryx、NVKE 文档:软件版本与成熟度优先于热榜。
- Arete、DSpine、Nemotron Parse和 Cola2:权重角色、许可与评测条件逐项检查。
- 本期全量原始素材保留各流摘要、原始链接、计数口径与覆盖缺口;本篇只选高权重主线,不代表归档中的每条候选均已独立复现。
今日行动建议
- 记忆产品先分开测“记得对”和“用得有界”:给每条记忆保留出处、作用域、失效条件,不让偏好自动替代高风险操作批准。
- 后训练团队重做一张完整预算:教师训练、学生蒸馏、生成、同步和验证分列,先明确目标模型,再讨论局部倍速。
- 企业 agent 团队选一个稳定的只读环境试验索引与表示优化,保留独立验证集、权限继承与回滚,不靠代理自评宣布降本成功。
- 工具维护者优先评估 Transformers v5.22.2,核对模板与多卡回归;Claude Code 的社区修复版本说法等一手发行说明再采信。
- 手机自动化与 GPU 平台试用坚持非生产、最小权限和明确停止入口;README 的保护声明与 Preview 身份都不能当上线批准。
- 模型评测者固定目标权重、推理档位与硬件,分别验草稿组件吞吐和任务质量;训练集、权重、代码分别查许可。
- 财经与产品写作者以正式文件和发布说明为准:不把估值转述写成定价,不把研究命名、入榜或仓库修改当产品首发。