一分钟速览
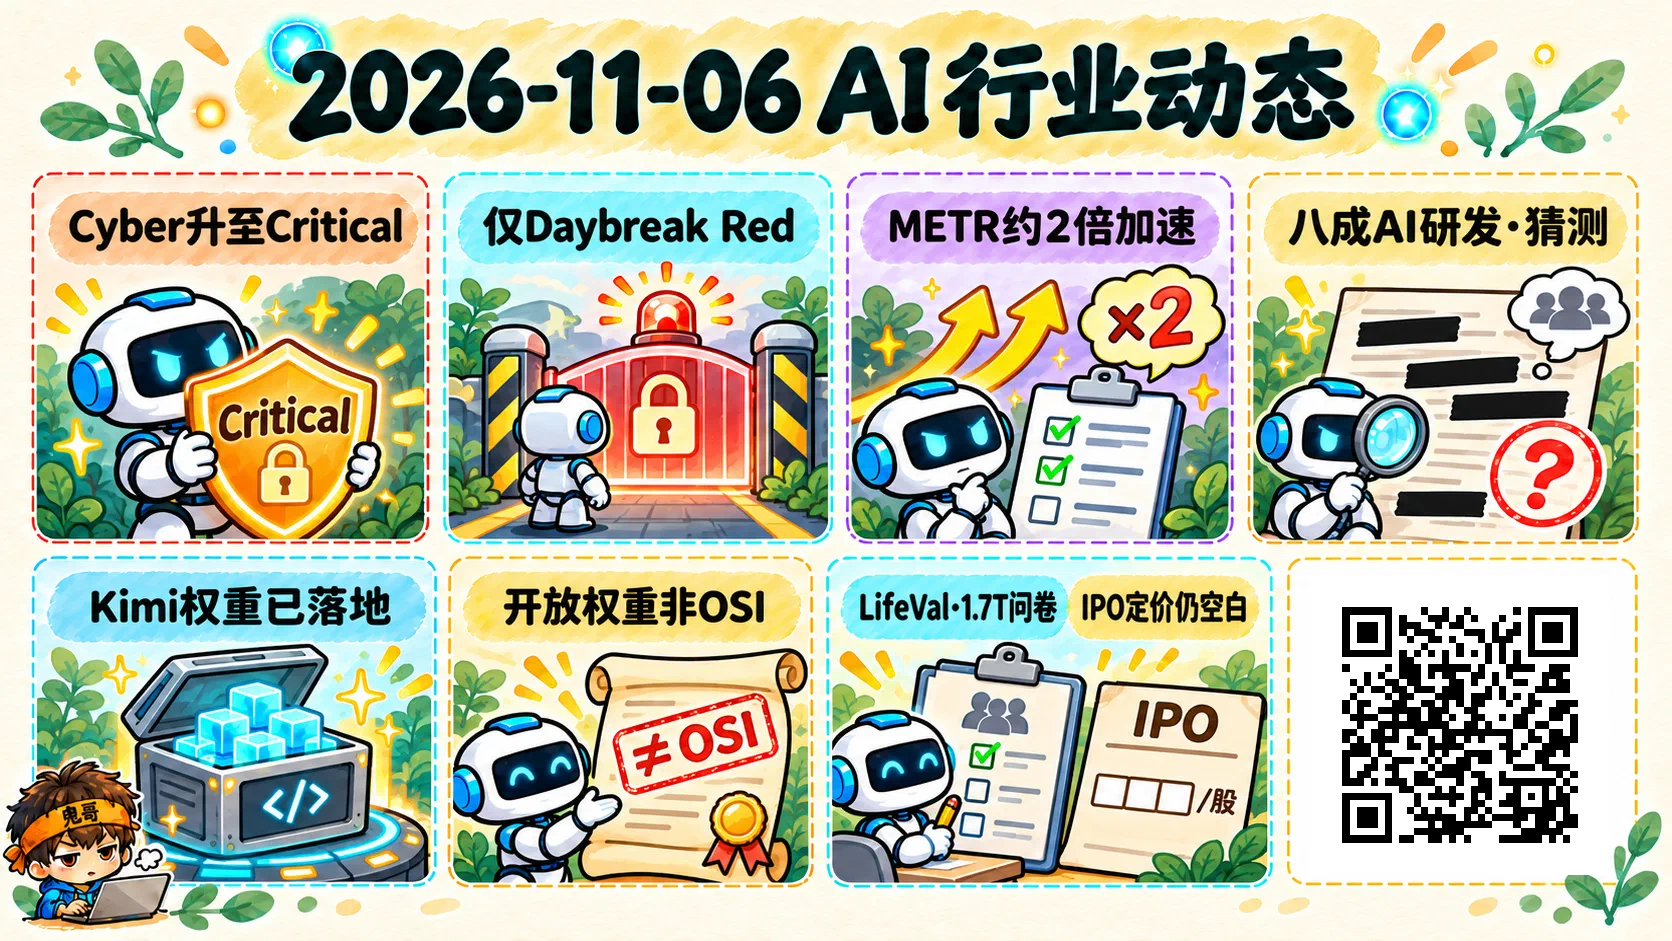
- 本期覆盖 11 月 3 日上午到 11 月 6 日上午约 3 天(Asia/Singapore):官方安全模型、独立评估、开放权重落地和本地推理版本是主轴。
- OpenAI 称发布 GPT-6 Cyber,Preparedness 网络安全档升至 Critical,目前只对部分 Daybreak Red 客户开放;同源 Linux 管线一次运行复现 1,724 个候选、产出 948 个本地提权结论,API 成本约 121.3 万美元(官方自述)。
- METR 独立评估称 Anthropic 在明确任务上的进步速度约是此前的 2 倍;「约八成加速来自 AI 做研发」是猜测而非结论,多数关键证据被涂黑。
- 上期写「尚未上 HF」的 Kimi K3.1 Pro 权重已落在官方仓 moonshotai/Kimi-K3.1-Pro:开放权重、自定义许可,不是 OSI 开源;年营收超 2,000 万美元的 MaaS 须另签协议。
- LifeVal 完整论文给出约 1.7 万亿美元年化支付意愿,属问卷估算;llama.cpp v0.9.0 发正式版;Anthropic IPO 最新文件仍是 11-02 的 S-1/A,价格与股数空白。
执行摘要
- OpenAI 把 offensive agent 能力推到 Critical 档,同时用准入把范围锁在 Daybreak Red;数字一律按官方自述写。
- METR 给出约 2 倍加速的外部意见,但涂黑幅度本身就是新闻;「八成来自 AI 研发」不可写成定论。
- Kimi K3.1 Pro 权重兑现,许可证把「自己跑」和「卖推理」拆开;冒名仓仍在,只认官方组织。
- LifeVal 从示例分变成可引用任务集与问卷估算;消费侧 agent 评测有了更硬的尺子。
- 本地推理侧 llama.cpp 升到 0.9.0;本机 agent 自动化中台和官方 SDK 缓存/驻留能力继续加厚。
- Anthropic 上市文件无新修订;Personal Finance、Cursor Live Apps 是产品侧的增量。
大厂与学术界动态
主线:OpenAI 称 GPT-6 Cyber 达 Critical,只开给 Daybreak Red;同源管线给出 Linux 规模数字
这是本窗口最硬的官方发布,但必须按「OpenAI 称」来写,并只写能力结论与准入范围。OpenAI 于 11 月 5 日(美东)发布 Introducing GPT-6 Cyber,X 官宣约在 11 月 6 日 01:09(Asia/Singapore)。模型面向授权安全研究,不是给普通 ChatGPT 用户;目前只对部分审核通过的 Daybreak Red 客户开放 API/Codex,后续再扩大。配套还有 Private Safety Processing(零数据保留客户默认走自动安全审查、人员看不到明文)、Daybreak Red 默认 IP 白名单,以及面向关键基础设施防御方的 Daybreak Red 分组。11 月 12 日 10am PT 有一场 Cyber livestream(官方自述)。
能力数字全部来自 OpenAI 自述,X 包与研究包两边都有、已合并为一处,以官博为准。Preparedness Framework 的网络安全档从 GPT-5.6 Cyber 的 High 升到 Critical。ExploitGym 得分 48.5%,上一代 GPT-5.6 Cyber 为 32.1%,相对约 +51%。范围对齐评测 ExploitGym Honeypot:无部署提示时,不越权攻击范围外服务的比例为 99.93%(上代 94.49%);加部署提示后为 100%。RemoteExploitBench 上,GPT-6 Cyber 完成率 95%,GPT-6 Astra + Daybreak Blue 拒答率 100%。Firefox 侧,OpenAI 称发现 81 个 Mozilla 标为高危的此前未知漏洞并协助出补丁。以上均为官方自述,不展开任何利用细节。
同窗前一天的 A thousand fewer paths to root 给出了规模量级。OpenAI 称一次运行:候选经动态复现得到 1,724 个,产出 948 个可在标准桌面配置上工作的 Linux 本地提权(LPE)结论,另有信息泄露类 PoC;API 成本约 1,213,430 美元,约合每个 LPE 1,279 美元。相对 7 月用 GPT-5.6 Sol、同一 harness 做出的 166 个 LPE,约为五倍以上。采样 166 个结论中,称至少 10 种对专家来说是新的手法,细节未公开。kernelCTF 类环境另有一组较小数字(官方自述)。这条管线写明用的是即将发布的 cyber 模型,与 GPT-6 Cyber 形成闭环。
对安全团队和开源维护方,这条线的含义很清楚:能力被官方写成 Critical,但入口被关在审核过的防御方;Linux/Firefox 数字则给出了「按流水线扫」的成本和产出量级,会影响安全预算讨论。对普通开发者和 ChatGPT 用户,本窗口没有可用的公开入口,也不应据此假设自家环境已被同等能力扫过。政策读者可对照上期 Anthropic S-1/A 里 RSP「可能很快」触及加速门槛的措辞——两边都在用正式文件或正式框架给「能力越线」打时间戳。
深入学习建议
- 先读 GPT-6 Cyber 原文 的准入、Honeypot 对齐与 Preparedness 段落,只记结论数字。
- 再读 Linux 管线文 的成本表与规模数字,不要追利用细节。
- 做防御规划的团队,对照自己是否在 Daybreak Red / 同类授权渠道的覆盖范围内,以及内核与浏览器补丁节奏。
主线:METR 评 Anthropic 进步约翻倍,「八成来自 AI 做研发」是猜测,多数关键证据被涂黑
这是对上期 S-1/A 里「可能很快触及 RSP 加速门槛」最重要的外部对照,读法必须谨慎。METR 于 11 月 5 日发布 Anthropic AI R&D Acceleration Assessment,评估期约 8 月 12 日到 10 月 29 日,约 2.5 人全职当量,不收 Anthropic 的钱。公开结论偏谨慎,但删减幅度本身也成了新闻。
可公开的硬数字里,内部 AECI(Anthropic 版 Epoch 能力指数)自 2025 年 10 月起增速约 1.9×(95% 置信区间 1.5–2.8);换链路函数后结果在 1.1–2.9×;纳入其他公司模型则约 1.4×。METR 写明:加速不是训练算力增速变快导致的。主观总判断(METR 自述,团队有分歧):截至 2026 年 10 月,Anthropic 在「目标明确的任务」上提升能力的速度,大约是 2024 年 3 月到 2025 年 10 月那一档的 2 倍;真实值在 1.3–3 倍都不意外。旁证里,员工 Slack 投票自评最新模型让自己快约 12 倍,METR 称证据很粗;AI 尚未能独立完成训练最关键环节,但已有「signs of life」。
必须单独标清的一句:当前加速的大部分「或许约 80%」来自用 AI 做研发——这是猜测与情景判断,不是结论。2025 年底那波加速里,非 AI 因素可能很大。把「约八成」写成定论,会直接误导 IPO 路演和 RSP 讨论。
涂黑部分同样重要。约 100 页完整报告中,Anthropic 单方面删掉了 METR 认为最有说服力的大部分证据(算法进步估算、训练各环节加速、对未来模型的预测等),理由是可能帮竞品加速;算力在「能力 vs 安全」之间的分配核查中途被取消。Anthropic 侧,Sam McCandlish 称许多结论与他一致,并预告未来几周发自家报告对照 RSP;联合创始人侧未否认加速,但强调不确定性(待核细节以 METR 原文与其回应帖为准)。
和上市文件放在一起看:截至 11 月 6 日上午,EDGAR 上 Anthropic 最新仍是 11 月 2 日的 S-1/A,没有更新价格区间或发行股数的新修订;价格、股数、募资额仍是空白,不推测。市场对 1.5 万亿估值的怀疑、下修或推迟传闻均非公司公告,待核,本篇不采信为事实。
对政策与安全读者,先读 Executive summary 和 redaction 表,再对照上期 S-1/A 的 RSP 措辞;对财经写作者,AECI 区间可以引用,员工「12×」自评和「八成」猜测不能直接换算成公司加速度。
深入学习建议
- 读 METR 原文 的公开结论与涂黑说明,区分硬数字、主观判断和猜测。
- 对照 S-1/A 索引页,确认价格与股数仍空白。
- 等 Anthropic 自家对照 RSP 的报告,再决定是否修正「加速来源」叙事。
主线:LifeVal 完整论文落地:个人助理任务可打分,约 1.7 万亿美元年化 WTP 是问卷估算
上期 LifeVal 官博 只放了示例分;本期论文把尺子补齐了。OpenAI 的 LifeVal(arXiv 2611.06687) 覆盖 148 类人生任务(找幼儿园、找房、做食谱、办政府业务等),强调测的是 agent 能否动手完成,而不是答题。论文在 169 个任务上评了 GPT-5.2 / 5.4 / 5.5 / 5.6 与 GPT-6 Astra;自动评分与人类在 30 任务子集上均值 84.20% 对 83.61%,Pearson r=0.864(作者自述)。
最容易被误读的数字是支付意愿(WTP)。论文在自身问卷口径下给出年化 WTP 合计超过约 1.7 万亿美元;问卷 n=3,837,筛选后保留 1,826。这是调查估算,不是市场规模实测,也不是收入预测。写财经稿或做预算时,必须保留「问卷估算」四个字。
同窗还有几条研究侧信号,权重够不上独立主线,但和「agent 能不能信」同一条河。Thinking Machines Lab 的 PEARL(arXiv 2611.05358) 比较事后压制错位行为的方法,称在宽触发上压制后即使再喂不安全代码也不易反弹(作者自述,待核复现条件)。Microsoft Research 的 AC3(arXiv 2611.00518) 指出,工具场景下粗暴丢掉助手历史会把成功率打到 0,agentic 上下文管理可弥合 full-context 与粗暴截断差距的 55–84%(作者自述)。NVIDIA 的 Chunk-Indexed Sparse Attention(arXiv 2611.03200) 把已训稠密注意力改成稀疏、不重训,自称 1M prompt 末端核心注意力 prefill 约 11.7×、decode 约 13.0×(作者自述)。
适合做个人助理产品、消费侧评测和长对话工程的人。LifeVal 的价值在任务分布与评分口径,不在那个 1.7 万亿的标题党读法。
深入学习建议
- 先读 arXiv 2611.06687 的任务分布与 WTP 方法部分,再对照上期 官博。
- 做长对话产品的读 AC3;做对齐事后修复的读 PEARL。
- 引用 1.7 万亿时,固定写成「论文问卷估算的年化 WTP」。
X 动态
主线:Claude 美区上线 Personal Finance:Plaid 只读连银行,明确不能管钱
产品向「连真实账户」又走了一步,但比外界想象的窄。Anthropic 于 11 月 6 日约 02:00(Asia/Singapore)通过 @claudeai 与 产品文 宣布:美国 Pro / Max / Ultra 本周起 beta,侧边栏出现入口即轮到;免费、Team、Enterprise 无。能力是用自然语言问余额、分类支出、账单、异常扣款,可生成图表与日历;最多连 16 家机构,最多约 24 个月交易。
安全叙事是这次对外的主轴:经 Plaid 授权,只读;Claude 看不到银行密码,不能移动、管理或投资资金;无广告、无自营信贷产品;理财 hub 内对话不用于训练(官方自述)。第三方整理称,OpenAI 5 月已有类似 Finances,ChatGPT 侧还能读投资持仓并做更宽的规划话术,Claude 明确不提供投资建议(待核对比细节以两家帮助中心为准)。解绑后数据保留时长,Claude 帮助页写得不如 OpenAI 明确——待核,以帮助中心原文为准。
对美国付费用户,这是高价订阅继续往垂直场景叠能力;对隐私读者,「只读 + hub 内不训练」是可核对的承诺,绑定前应读完授权范围。它和上期 Ultra 取消 5 小时限额、本期 METR/IPO 讨论叠在同一周,商业化节奏与治理叙事是并行的,不要混成一条因果链。
深入学习建议
- 美国 Pro/Max/Ultra 用户读 产品文 与帮助中心绑定步骤。
- 隐私读者对照 Plaid 授权范围和「理财 hub 对话不训练」表述,并核了解绑后保留时长。
- 做金融 agent 的人,把「不能转账、不管钱、不投资」当成产品边界样板,而不是功能清单。
主线:Cursor Live Apps 上线;浏览器 agent 补丁债在 Playwright 1.65.0 上越过修复线
编码 agent 的产品面和供应链面本窗口各有一条进展。Cursor 于 11 月 6 日约 05:41(Asia/Singapore)称推出 Live Apps:在编辑器里用自然语言搭应用,按需建库、跑确定性与 agent 安全检查、部署到可分享链接,面向开启 cloud agents 的付费计划(官方帖,官方自述)。X News 称支持 Postgres、Cursor SSO 等,细节以官方文档为准,待核。上期扩展市场投毒事件本窗口无新的受害者统计或新恶意版本通报;用 Cursor 的人仍应确认 Claude Code 扩展不低于 2.1.314。
浏览器侧,上期点名的 Playwright 1.64.1 / Chromium 156.0.8078.4 落后于 CVE-2026-118306 修复线(156.0.8078.73)的问题,在当前 latest 上已越过:npm playwright@1.65.0 捆绑 Chromium 158.0.8127.18(已核)。是否默认开沙箱仍需部署方自查。AGENTS.md 劫持相关的 Codex issue #41499 仍为 open,最后更新仍是 2026-08-29,本窗口无补丁。
适用场景清楚:要「描述即部署」的个人和团队可以试 Live Apps,但要把安全检查声明和上一轮扩展投毒放在一起评估;跑 headless 浏览器 agent 的团队,确认实际 Chromium 已到 1.65.0 所带版本或更高,并自查沙箱策略。
深入学习建议
- 读 Cursor Live Apps 官方说明,核对 cloud agents 权限与部署范围。
- 用
playwright --version/ browsers 清单确认 Chromium ≥ 158.0.8127.18,并对照 NVD 条目。 - 继续跟踪 Codex #41499,在厂商补丁前不要假设 AGENTS.md 劫持已消失。
热门开源项目
主线:llama.cpp v0.9.0 正式版:FP8、多序列 KV 与多后端并行一起到
本地推理本窗口的版本锚是 llama.cpp v0.9.0(11 月 4 日 21:08 Asia/Singapore),底座 ggml 升到 v0.29.0。量化侧新增 OCP FP8 E4M3;推理侧用 flash_attn_ext_rows 让统一 KV cache 在多序列场景更高效,并恢复非统一 KV 的 prefill 表现;ggml 还带来 NCCL 多节点张量并行,以及 CPU / CUDA / SYCL / Metal / Vulkan / OpenCL / Hexagon 各后端的性能工作。新架构包括 Clover、Limite、Metis-1.6 和 Mistral Large 4;音频侧扩展 Chatterbox TTS、Nemotron 3.5 Transcribe 与 Pocket TTS 预置音色;Gemma 4 E2B/E4B 的 prefill 也有大改。API 有一批 mtmd.h / server TTS 相关变更,升级前必须对照 changelog。
对做本地多序列服务、想试 FP8、或刚拿到 Large 4 GGUF 的人,这是应先看的一版。它和上期 vLLM / SGLang 的「投机解码 + MoE 调度」主线不同:llama.cpp 继续把消费级与跨后端本地部署的地板抬高,而不是和云端引擎抢同一套叙事。
深入学习建议
- 读 v0.9.0 Release 的 breaking / API 变更,再决定是否升级 server。
- 有多机需求的,重点看 ggml NCCL 张量并行与各后端说明。
- 跑 Mistral Large 4 GGUF 的,用本版复测 prefill / decode,不要沿用旧版数字。
主线:本机 agent 自动化中台冲星,OpenAI SDK 继续把缓存和驻留写进接口
窗口内新仓星数第一是 KKKKhazix/agent-autoloop:11 月 3 日 16:02 新建,截至 11 月 6 日 09:19 约 3,242 星。定位是本机「自动化中台」——把定时任务、GitHub Issue、业务告警变成标准事件,调度已登录的命令行 Agent 在后台接活;平时不打扰,拿不准时才把卡片推到飞书 / 钉钉 / 企微 / Slack / Discord 或桌面通知。内核零外部依赖,事件源、Agent、通知通道都是插件,自称一行配置即可接入「能接收提示词并打印最后回复」的 CLI Agent。macOS / Linux 可用,Windows 仍在开发(项目自述)。想让本机 Agent 从「守着终端」变成「后台接单」的人值得试;生产前自行评估权限与费用统计口径。
平台 SDK 侧,OpenAI 两个官方 SDK 在窗口内连发多版:Python 从 v3.43.0 到 v3.47.0,Node 同步到 v7.52.0 一带。值得单独拎出的有:Live Responses 委托工具扩展、Responses 的 12 小时缓存与 cache-write 用量、模型目录加入 GPT-6 Rosalind、澳大利亚 / 印度 / 日本数据驻留选项,以及图像复杂度与 GIF / SVG 输出控制。上期刚写过 agent compaction / session review,这一波是把长会话、缓存和区域合规继续收进 SDK。
日榜上,NVIDIA/auto-ontology 以约 2,679 stars today 排第一(抓取于 11 月 6 日 09:19,总星约 7,377):企业本体 / 语义层,给 agent 提供指标、实体与血缘的可信含义,经 MCP / CLI / API 对外。窗口内有版本 bump 到 1.2.0 的提交,尚无 GitHub Releases 页;README 写明当前不接受外部贡献。ComfyUI v0.44.0 则把视频侧节点(MiniMax H3 系列、Flux Video Upscale 等)推进一步,做 AI 视频工作流的人可升。
深入学习建议
- 试 agent-autoloop 前先画清本机 Agent 的权限边界和通知策略。
- 对照 openai-python / openai-node 近五版 changelog,列出可删的自研缓存与驻留逻辑。
- 做企业数据分析 agent 的,读 auto-ontology 的定位,评估是否需要语义层而不是只堆工具调用。
模型相关
主线:Kimi K3.1 Pro 权重落地官方仓:开放权重、自定义许可,不是 OSI 开源
上期明确写「截至 11 月 3 日上午仍未上 Hugging Face」;本窗口这件事落地了。官方组织账号 moonshotai/Kimi-K3.1-Pro 可访问:约 96 个 safetensors,Trending #1,likes / downloads 约 928 / 11,658(采集时点)。卡片与 README 自述:原生多模态 agent 模型,MoE 总参约 2.8T、激活 104B、93 层、896 专家每 token 选 16、上下文 1,048,576;量化为 MXFP4 权重 / MXFP8 激活(QAT);HF 统计约 2.780T。时间线需写清:HF createdAt 为 11 月 2 日 12:13(Asia/Singapore),但 11 月 3 日采集时组织列表未出现该仓;本窗 lastModified 11 月 5 日 15:11 有 encoding 更新。Artificial Analysis 已把标注从非开放权重改为 Open weights,智能指数 46.5(v5 口径),并反链该 HF 仓库。
许可证是关键读点。自定义 Kimi K3.1-Pro License(license: other):允许使用、修改、分发;但若运营 Model as a Service 且连续 12 个月营收超过 2,000 万美元,须先与 Moonshot 另签协议;超 1 亿月活或月收入超 2,000 万美元的产品界面须显著标注型号名。内部使用和官方 / 认证推理伙伴不受前述商务条款约束。一句话:开放权重,不是 OSI 开源。 官方博客 kimi-k3-1-pro 正文仍写 “Full model weights will be released by Nov 4, 2026”,没有改成「已发布」,也没有在博客页加 HF 链接——以权重与官方组织证据为准,视为承诺期内已兑现,并注明博客未同步。
冒名与虚假仓继续存在,不放链接:上期已标冒名的同名「unrestricted」仓仍无权重;自称 Anthropic 检查点泄露的 numbat 仍在 Trending,社区审计指出权重可由张量名哈希复现,已判定为假。只认 moonshotai 官方组织。社区 pruned / abliteration / 镜像变体均非官方,许可与对齐自担。厂商自测「接近 Opus 5.5」的分项、社区测算「权重约 1.56TB」均待核。
生态上,微软 Foundry、AMD Instinct MI355X Day-0、Verda Inference 预览等有官方或合作方信号(待核细节以各方公告为准)。适合长上下文 agent、需要开放权重部署的推理团队;要做 MaaS 且年营收可能过线的,先读许可证第 2–3 条再谈商务。
同窗另有两条次级新发:ricursiveAI/Ripple-65B-Preview(Apache-2.0,约 65B 稠密,README 称 12T token 预训练、最长 1M 上下文,自报基准待核);speridlabs/idol-turbo(上期 Idol 的 5 步蒸馏加速版,自称约 0.75s,待核)。LMArena 文本 / 视觉未刷新;文生图榜刷新到 Nov 2,GPT-Image-2.6 进入预备档。AA 首页默认图实质变化:Kimi 改为 open,并新进闭源 Tencent Hy4(34.6)、Inkling 2 Small(30.6)。
深入学习建议
- 只从 moonshotai/Kimi-K3.1-Pro 下载,先读 LICENSE 第 2–3 条。
- 对照 技术博客 与 HF 卡片,记下博客尚未改写「已发布」的事实。
- 做第三方评测的,盯 Terminal-Bench / SWE 等厂商自测与复测差;不要下载任何冒名或「泄露检查点」仓。
次要动态
大厂与产品
- Anthropic 科研用法:How researchers use Claude 分析 2026-08-02 至 09-30 共 207,000 次科研相关会话(Claude 128,914 + Claude Code 78,135);数据分析约占 Claude 会话三分之一、Claude Code 近一半(官方自述)。产出情景(广泛采用可使部分领域约翻倍等)为情景待核。
- Anthropic vault 研究:称用 Claude 协助解析原核 vault 三维结构;分离流程约 90 分钟、34 小时出第一版模型等为官方自述;预印本未同行评审,只记结论。
- DeepMind Antigravity 化学信息学:官博 演示剂设计迭代,称约 1 小时完成原需多日的循环,并向 10,000 名科学家提供 6 个月最高用量档申请(官方自述);强调须实验验证。
- Microsoft Research PDD Kit:形式化验证 agent 写的全栈 Rust,Pet Store 约 5,000 行案例(官方自述);研究原型,目前仅 Rust/Verus。
- Meta GSLM2:论文页 · arXiv 2611.01143 · 代码;称约 6M hours / 6.5B params,口语–文本差距缩小约两个数量级(官方自述)。
- OpenAI 其他:Images 2.6 称生成快 50%、全平台周约 40 亿图(官方自述);收购 Pierre(Code Storage/Diffs,衔接上周 Pando,交割待监管);Daybreak Red 登陆 AWS GovCloud US-East(原文)。
- Google Gemini Omni 1.2 Flash:博客 称原生最长 15 秒视频、开发者侧价格降约 30%(官方自述)。
- NVIDIA CUDA 13.5:Vera Rubin GA 支持。
- 追踪项:蒸馏报道三方仍无公司层面回应;GPT-6.2 Astra/Sol、Fable 5.5 仍无官宣,截图级传闻待核或不采信;Codex/ChatGPT 共享额度本窗口无新的生效日或额度数字;Navier–Stokes 外部数学核查仍无独立定论;#41499 仍 open。
论文备选(作者自述,待核复现)
- Apple 感知人形运动 2611.06908:实物 91% 成功率(360 trials / 6 场景)。
- MSR Rubric Curriculum RL 2611.06244;GDM Parallel Reconsideration 2611.05724;UK AISI 相关 2611.04260 · 2611.04556。
开源与模型旁线
- Ripple-65B-Preview、idol-turbo 见模型主线末段;上期 Mage-VL-Cowork / SenseNova-Loop / DSV4.1-NVFP4 等无新权重级事件,热度延续。
- 冒名 / 虚假仓:仅写判定、不放链接——Kimi 冒名「unrestricted」仓仍无权重;numbat 仍判定为假。
来源与延伸阅读
- OpenAI:GPT-6 Cyber · Linux 管线 · Images 2.6 · 收购 Pierre · Daybreak Red GovCloud
- METR:Anthropic AI R&D Acceleration Assessment · Anthropic S-1/A 索引
- LifeVal 论文 2611.06687 · LifeVal 官博 · PEARL 2611.05358 · AC3 2611.00518 · CISA 稀疏注意力 2611.03200
- Anthropic:科研用法 · vault 研究 · Claude Personal Finance
- DeepMind Antigravity 化学信息学 · Gemini Omni 1.2 Flash
- MSR PDD Kit · Meta GSLM2 · GSLM2 代码 · CUDA 13.5
- Cursor Live Apps 帖 · NVD CVE-2026-118306 · Codex #41499
- llama.cpp v0.9.0 · agent-autoloop · auto-ontology · ComfyUI v0.44.0 · openai-python releases · openai-node releases
- moonshotai/Kimi-K3.1-Pro · LICENSE · Kimi 技术博客 · AA Kimi 页 · Ripple-65B-Preview · idol-turbo · AA 模型榜 · LMArena 文生图
今日行动建议
- 安全与平台团队:按 OpenAI 官方口径理解 GPT-6 Cyber 的能力结论与 Daybreak Red 准入;不要在未授权渠道追利用细节,优先核对内核与浏览器补丁节奏。
- 政策与财经写作者:读 METR 公开结论与涂黑表;「约八成加速来自 AI 研发」只写作猜测;引用 Anthropic 上市信息时确认最新仍是 11-02 S-1/A,价格与股数空白。
- 自托管与 MaaS 团队:只从 moonshotai/Kimi-K3.1-Pro 拉权重,先读自定义许可证第 2–3 条;年营收可能超过 2,000 万美元的推理服务先谈商务。
- 消费侧 agent / 评测:用 LifeVal 论文的任务与评分口径,引用 1.7 万亿时固定标注「问卷估算」。
- 本地推理:升级 llama.cpp 0.9.0 前对照 API 变更;浏览器 agent 确认 Playwright ≥ 1.65.0(Chromium 158.0.8127.18)。
- Cursor 用户:试 Live Apps 前评估 cloud agents 权限;扩展版本仍不低于 2.1.314。
- 本机想把 CLI Agent 变成后台接单的,评估 agent-autoloop 的权限与通知边界后再上生产。
- 不下载任何冒名 Kimi 仓或自称泄露的前沿检查点;LMArena 文本尚未纳入 K3.1 Pro,第三方复测前不要只拿厂商分项做采购依据。