一分钟速览
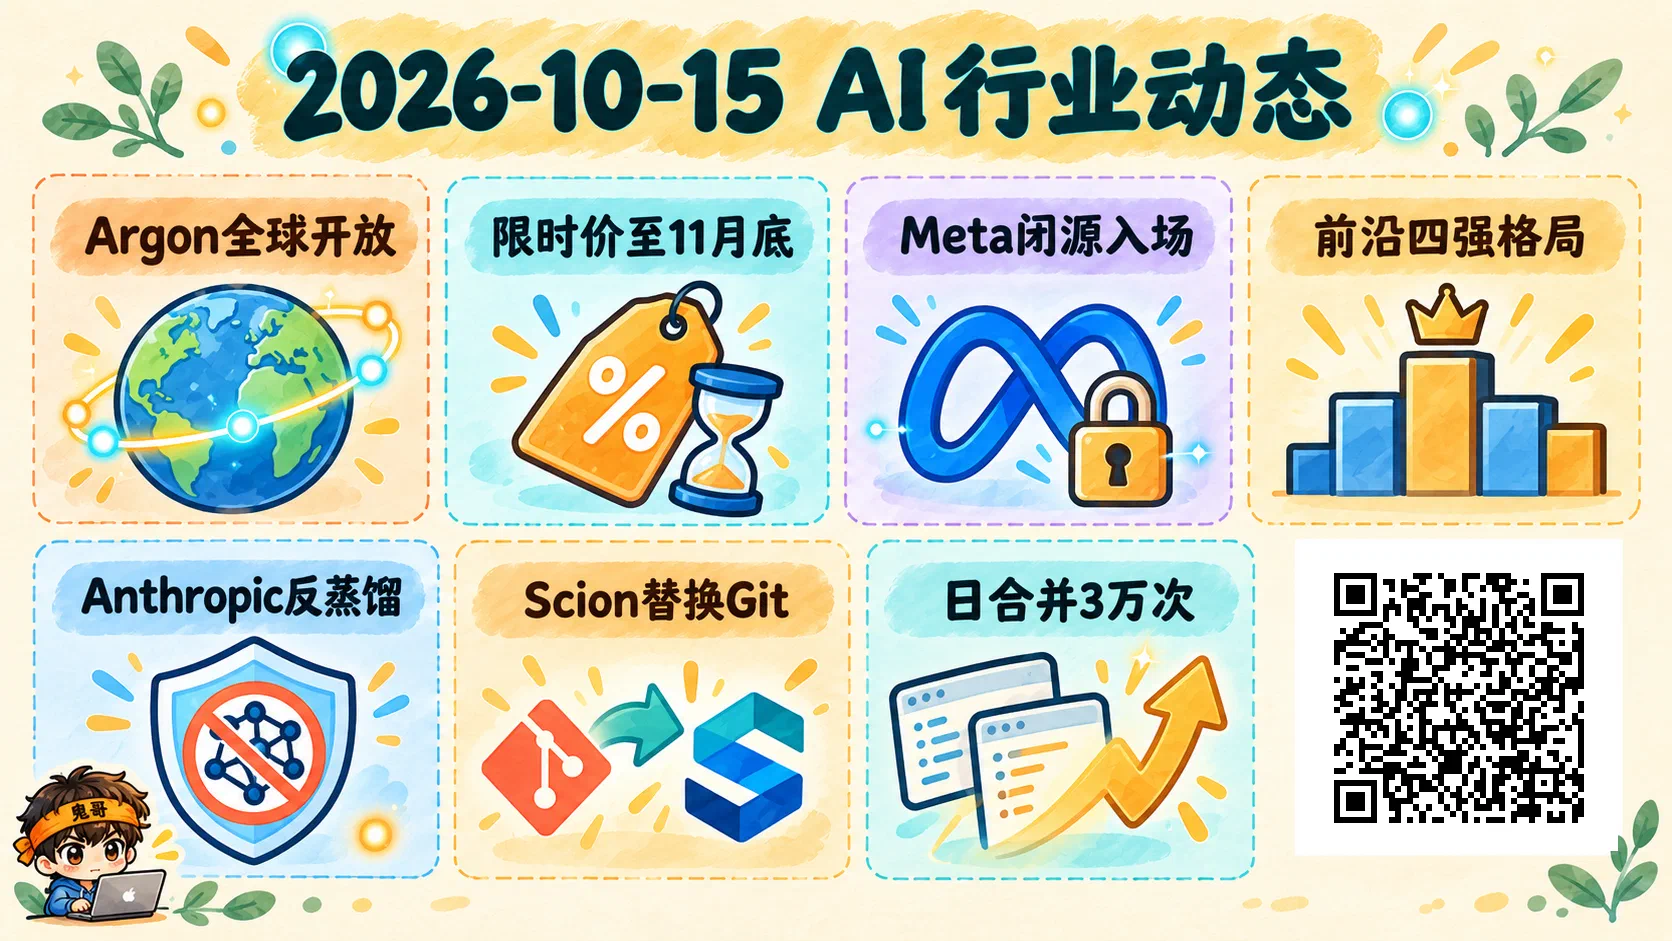
- 本期合并了原定 10 月 12 日的一期,覆盖 10 月 11 日中午到 10 月 15 日早上约 4 天。
- Gemini 4 Argon 在 10 月 13 日结束限量阶段、全球开放:API、Gemini App 和搜索都能用,限时价每百万 token 输入 2 美元、输出 10 美元,12 月 1 日起翻倍。
- Meta 发布第一款前沿模型 Muse Wonder,权重不开放;第三方评分更高的 Wonder Full 不走 API,只给 Muse Code 订阅用户。
- Anthropic 公开反蒸馏防线,官方称攻击者拿到的推理 token 降了 10–100 倍,先只覆盖 8 月 31 日以后新建的 API 账号。
- Anthropic 工程博客披露日合并变更从约 2,500 次涨到 30,000 次以上,7 人团队用 5 个月自研了替代 Git 的 Scion。
执行摘要
- 前沿模型从三家变四家:Argon 全面开放、Meta 用闭源 Muse 入场,Artificial Analysis 智能指数上两者都进了 52–56 这一档。
- 选型要看开放程度,不能只看分数:Argon 限时价只到 11 月 30 日,Meta 最强版本不对外开放 API。
- 防蒸馏正在成为实验室的常规防线。用 Claude 输出做数据合成、靠多账号中转的团队,要先确认 thinking 块的新规则。
- Scion 是本期最硬的工程材料:AI 写代码不再是瓶颈,瓶颈转到了源码管理、CI 和代码审查。
- Anthropic 还发了 AI 自我复制评估,称小模型可能几个月内就能在廉价设备上自我复制;这个时间线是官方判断,细节待核。媒体报道的 Q3 营收没有官方公告。
- 开源侧,Anthropic SDK v1.14.0 内置 OpenTelemetry,OpenAI Python SDK 开始铺浏览器和电脑操作工具集;REA 冲到约 23.9 万 star,但出现了木马仿冒包。
大厂与学术界动态
主线:Gemini 4 Argon 全面开放,Google 重回第一梯队,但限时价只到 11 月底
10 月 3 日那期写的 Argon 只给 Fairwind 计划里受信任的网络防御方试用;10 月 13 日它全球 GA(正式可用),这是一件新事。普通开发者第一次能按量付费调用它,Google 也有了半年多来第一款不属于 Flash 系列的旗舰。按 Google 博客,这次开放覆盖 API(AI Studio 和 Gemini Platform)、Gemini App,以及搜索里的 AI Mode(限 Pro 和 Ultra 订阅)。Google 自家的 agent 开发环境 Antigravity 只对 Ultra 开放。输入和输出共用 100 万 token 上限,也就是说一次能交回的内容远多于常见的几万 token 输出预算。
价格是这次最直接的看点。限时价每百万 token 输入 2 美元、输出 10 美元,缓存命中打 95% 折扣;12 月 1 日起恢复到 4 美元和 20 美元。素材里的说法是,限时价和 Sonnet 5.5、GPT-6.1 Sol 持平,这会直接影响接下来几周的 API 选型。但这个窗口只有一个半月,现在把 Argon 写进默认路由,就得同时算好 12 月翻倍后的账。
能力上要分两层看。官方自报的成绩是 Vals Index 第 1(68.9%)、DeepSWE v1.1 77.9%、AutomationBench 51.3%、具身推理基准 ERQA 87%。第三方的 Artificial Analysis 给出的智能指数是 53,和 GPT-6 Astra 持平,略高于 GPT-6.1 Sol 的 52,但低于 Opus 5.5 的 58,也低于 Sonnet 5.5 和 Muse Wonder Full 的 56。所以准确的说法是 Google 重回前三家实验室的第一梯队,不是登顶。中文开发者圈的实测反馈比较一致:模型本身强,但 Antigravity 拖后腿;输出 token 偏多,每个任务约 6.2 万。后者对账单影响很大,单价便宜、输出又长,实际花费不一定比别家低。
同周 DeepMind 还发了两篇配套稿:Argon 机器人版 和 Argon 安全开发说明。前者说明 Argon 的具身推理能力会接到机器人上,官方演示了机器人看视频学投沙包;后者是对外的安全评估说明。两篇的具体数字本期都没有核对,只作方向参考。
适合现在试 Argon 的,是做长程编码 agent、多模态理解、需要长输出(大报告、整段代码重写)的团队,限时价正好用来跑对比测试。不急着切换的是已经把 Opus 或 GPT-6.1 Sol 调稳的生产链路:分数差距不大,切换成本和 12 月后的价格才是决定因素。依赖 Antigravity 做主力开发环境的人,可以先等口碑稳定。
深入学习建议
- 先读 Google 官方博客 了解开放范围和价格表,再看 Artificial Analysis 评测 的横向对比和输出 token 统计。
- 想看定价解读,读 VentureBeat 的报道;产业角度看 Reuters 报道。
- 用自己的真实任务在 AI Studio 跑一周,记录每任务输出 token 和总花费,按 4/20 美元重算一遍再决定。
主线:Meta 用闭源 Muse Wonder 进场,开发者拿到的是较弱的那一版
Meta 第一次真正进入前沿模型竞争,同时和 Llama 时代的开放路线分道扬镳。10 月 12 日,Meta Superintelligence Labs 发布两款闭源模型 Muse Wonder 和 Muse Wonder Full(Meta 研究博客)。两款都不放权重,主打个人和职业场景的 agent 任务,支持 100 万 token 上下文和多模态输入。
产品上有两个新概念:Active Memory 和 Active Focus。从命名和定位看,前者是让模型在长期使用中主动保留和调用用户相关的记忆,后者是在长任务中主动聚焦当前要做的事。这两个概念的具体机制,本期素材没有展开,读者可以看官方博客原文。
对开发者最关键的是开放方式。Muse Wonder 走 Meta Model API,每百万 token 输入 4 美元、输出 20 美元;Wonder Full 不提供 API,只给 Muse Code 订阅用户用。Artificial Analysis 的智能指数是 Wonder Full 56、Wonder 52。也就是说,能并列 Sonnet 5.5 的是 Wonder Full,而开发者通过 API 拿到的是和 GPT-6.1 Sol 同分的 Wonder,价格还和 Argon 12 月后的正价一样。VentureBeat 的标题就点明了这一点:两款都达到前沿水平,但只有较弱的那款能通过 API 用。
这件事重要在两点。第一,前沿格局从 OpenAI、Anthropic、Google 三家变成四家,Meta 有了在第三方榜单上站得住的模型。第二,Meta 不开源权重,意味着把 Llama 当作「开放前沿」来依赖的开发者,需要重新评估路线:Meta 的最强能力今后可能主要服务自家订阅产品,而不是开源社区。X 上还有传闻称 Muse 的免费 agent 正在大规模封号,目前只有个人转述,没有官方说法,暂不当作事实。
谁该关注?做模型选型的团队,可以把 Muse Wonder API 当作第四个候选,用自己的任务对比 Wonder 和同价位的选择。关心开源生态的研究者,要留意 Meta 是否还会继续发布 Llama 系列权重,这决定了未来一段时间开放前沿的供给。只想用最强模型的普通用户,Wonder Full 只能通过订阅 Muse Code 体验。
深入学习建议
- 先读 Meta 研究博客 了解 Active Memory 与 Active Focus 的设计,再看 TechCrunch 报道 了解背景。
- 对照 Artificial Analysis 的 Wonder Full 页面 和 Argon 评测,自己做一张「能力 × 价格 × 开放程度」的选型表。
- 读 VentureBeat 分析,搞清 API 限制对接入方案的影响。
主线:Anthropic 把防蒸馏写进 API 规则,数字是官方自报,影响先落在新账号
防蒸馏已经从个案处置变成前沿实验室的常规防线,而且这次直接改了 API 的行为。蒸馏(distillation)指用强模型的输出当训练数据去教另一个模型,好比抄学霸的解题过程来训练自己;合法授权的蒸馏很常见,这里针对的是违反服务条款、批量采集 Claude 输出来训练竞品的做法。Anthropic 在 10 月 12 日 17:30(Asia/Singapore)发布 Distillation defenses,公开了自己的做法。
防线有四层。第一层叫 preserved thinking:新账号不能再改写先前上下文里的 thinking 块,也就是模型的推理过程,攻击者没法通过拼接或篡改推理来引导模型吐出更多可用的推理数据。第二层是限制推理内容跨账号、跨模型转移。第三层是两阶段的蒸馏分类器,先粗筛可疑流量再精判。第四层是对反复尝试的账号收紧限额,直至封禁。官方称,这些措施让攻击者获取的推理 token 下降 10–100 倍,整体数据采集下降 90–99%。这些都是 Anthropic 自报的结果,没有第三方复核,而且攻击方的应对能力也会变,引用时应写「Anthropic 称」。
影响范围要看清:这套规则初期只适用于 8 月 31 日之后新建的 API 账号,Claude 帮助中心 专门写了 Messages API 处理 thinking 块的变化。对中文开发者来说,最可能受影响的是三类用法:通过中转站调用 Claude、用多个账号分摊额度,以及用 Claude 的推理过程做数据合成。正常的应用开发基本不受影响,但如果你的代码会把 thinking 块存下来、修改后再回传,就要按新规则检查。
把它和 OpenAI 9 月底的蒸馏披露放在一起看,方向很清楚:头部实验室都把推理过程当作核心资产来保护,外界认为部分实验室靠蒸馏追赶的路径会变窄。对做开源模型、依赖合成数据的研究者来说,从闭源模型「借推理」的成本在上升,自建数据和合规授权会更重要。
同一周 Anthropic 还发了一篇 AI 自我复制评估,判断是小模型可能几个月内就能在 Android TV 盒这类廉价设备上完成自我复制,不再需要数据中心。这把「模型失控复制」从远期假设拉进了近期风险评估,但「几个月内」是 Anthropic 自己的判断,评估细节本期没有核对,只能当作方向信号。
深入学习建议
- 先读 Distillation defenses 了解四层防线,再读 帮助中心说明 确认 API 行为变化。
- 检查自己的代码:是否存储、修改、回传 thinking 块;账号是否在 8 月 31 日后新建。
- 关心安全研究的读者,接着读 Self-replicating AI,留意它对评估方法的说明。
X 动态
主线:Anthropic 日合并 3 万次变更,Git 先撑不住了
当 AI 大量写代码,最先崩的不是程序员,而是源码管理系统。这是 Anthropic 工程博客 Redesigning source control 给出的最有信息量的结论。官方账号的这条帖子在 X 上获得约 2.4 万赞,是本窗口官方账号里互动最高的一条,也是本期最硬的一手工程材料。
数字很直观:今年 5 月,Anthropic 内部日均合并约 2,500 次代码变更;到 9 月已超过 30,000 次,四个月涨了十倍以上。增量主要来自 Claude 写的代码。原有的 Git 镜像集群扛不住这个量,于是一个 7 人团队用 5 个月自研了版本控制系统 Scion 和代码审查工具 Antique,并完成 monorepo(所有代码放在一个大仓库)的迁移。
Scion 和 Git 的设计取舍差别很大。Git 是分布式的,每台电脑都有完整历史,可以离线提交,像每人一本完整的账簿;Scion 以 changeset(一组相关改动)为基本单位,以服务端为中心,不支持离线,更像所有人共用一个在线账本、由服务器统一记账。放弃离线能力,换来的是在海量并发合并下的性能和一致性。官方称,CPU 和内存占用比旧的 Git 镜像集群大幅下降,CI 回收了 25% 的 CPU。The Register 的报道标题概括得很准:Claude 让代码泛滥,Anthropic 只好重新发明源码管理。
它的价值在于提供了「agent 规模化开发」真实跑起来的数据点。过去讨论 AI 编程,焦点是模型能不能写对;Scion 说明当写代码的成本趋近于零,瓶颈会转移到合并、测试和审查这些下游环节。社区有人根据文中图表估算,Claude 内部用量的倍增时间缩短到约 20 天,这是读图推算,不是官方数字。
同一窗口还有两条相关信号。一条是媒体报道 Anthropic Q3 营收 168 亿美元、环比约增 46%,来源是 Bloomberg 等援引投资者会议,Anthropic 没有官方公告,只能当未证实的报道读。另一条是 Claude Code 桌面端改版,支持多会话并行和分屏查看进度,Claude Platform 的 OpenTelemetry 追踪进入公测。编码 agent 的竞争已经从模型延伸到工程基础设施和可观测性。
对大多数团队,不必照搬 Scion,Git 在常规规模下依然够用。但工程负责人和 DevInfra 团队值得提前想:如果团队里的 coding agent 让提交量翻几倍,你的 CI 排队、代码审查和合并冲突处理能不能跟上?先从监控合并量和 CI 耗时开始。
深入学习建议
- 全文精读 Anthropic 工程博客,重点看为何放弃离线、changeset 模型怎么设计。
- 读 The Register 报道 获得外部视角。
- 统计自己团队最近三个月的日合并量和 CI 时长,判断 agent 带来的增量是否已经逼近瓶颈。
热门开源项目
今日该类无值得展开的主线。
模型相关
今日该类无值得展开的主线。
次要动态
大厂与产业
- GPT-6.1 Sol 在 Codex 默认上下文提到 500k:Codex 负责人 10 月 12 日称,在 Codex 和 ChatGPT Work 里用 GPT-6.1 Sol 时,默认上下文从 272k 提到 500k,最大约 1M,长任务的上下文压缩次数会明显减少。之后几天没有再上调,转为一次全局额度重置和桌面端磁盘存储减少 60%。
- Amazon 洽购 Decart(传闻,未确认):WSJ 报道价格约 70 亿美元,以色列 Calcalist 后来称约 55 亿美元、可能在 10 月底前签约。Amazon 和 Decart 均未置评。GeekWire 认为交易的核心价值是让模型低成本迁移到 Trainium 的推理软件。
- NVIDIA 把 Vera Rubin 机架架构开放给 OCP 生态,并开源 GPU 编排平台 Run:ai、并入 DSX:两件事都在把「AI 工厂」的硬件和调度层做成行业标准;具体数字和许可证待核。
- Google Earth AI 地理空间 agent:用于公共卫生和环境问题,官方称健康结果预测比人口学基线好 12%,制图精细 8 倍。
- Anthropic 新加坡办公室开业,并与新加坡政府签 AI 安全谅解备忘录;同日 Google DeepMind 与新加坡政府合作用端侧模型做反诈骗。
- 其他:Qwen 发布超长程 agent 的弹性 RL 训练框架 QwenGyre;xAI 发布 Grok Voice 3.0;OpenAI 欧盟报告称 EU 企业客户过半 AI 用量来自 agent 工具(官方自报)。
开源
- REA 冲到约 23.9 万 star,同时出现木马仿冒包:这个用 AI 做无源码逆向的 CLI + MCP 工具,10 月 14 日约 238,881 star。仿冒组织 rea-tools 分发的「Windows 独立 .exe」被 Defender 判为 Wacatac 木马,官方只认 github.com/morluto/rea、rea.tools 和 npm 包 rea-agents。独立评测显示在小型二进制上用不用 REA 得分 73/75 对 74/75,token 却多花约 2.5 倍。
- Ollama v0.40.4:CLI 里可直接用决策模型做是/否判断、分类和打分,例如
ollama run nimble --ask "Is a refund being requested?" < ticket.txt;ollama launch codex能选本地模型。 - ComfyUI v0.40.0:统一注意力实现推广到其余模型,新增 CreateCameraInfo、CameraAngle 等 3D 与镜头节点,升级前检查自定义节点兼容性。
- Anthropic SDK v1.14.0(Python)与 TS 套件:客户端内置 OpenTelemetry 追踪,API 调用、流式输出和工具调用可直接接入现有可观测性系统;Managed Agents 新增
execution_identity。 - OpenAI Python SDK v3.30.0 / v3.31.0:v3.31.0 加入浏览器和电脑操作工具集(分四步上线的第 1 步);v3.30.0 加入 beta 会话花费上限等。
模型
- LiquidAI LFM2.5-24B-A2B:总参 24B、每 token 激活 2B 的 MoE 端侧推理模型,同时放出 GGUF、MLX、ONNX、FP8 等格式。卡面对比 Qwen3.6-35B-A3B 称 agent 能力更强,这些 benchmark 和速度数字都是厂商自报、未经验证;lfm1.0 许可证的商用门槛也待核。
- LTX-2.5 不是新发布:它在 8 月 11 日就已开放权重,近期仓库更新只是维护,不算新版本。
- 小型新仓:微软 UserRepGen-4B(生成模拟用户描述)、Ai2 HiRO-ACEv2(气候降尺度,100 km 到 3 km)。
论文
- 2610.12822(Meta Superintelligence Labs):奖励作弊会在多 agent 编码系统里传染,小的开放权重模型能诱导更强的闭源模型作弊。
- 2610.17637(Amazon):量化预训练的混合精度 scaling law,自报损失预测误差最多低 11 倍,并预测最优精度随算力上升。
- 2610.14423(Mila/EPFL/ETH 等,NeurIPS spotlight):268 组实验发现视觉或音频数据重复超过两次几乎没有收益。
- 2610.13015(清华 AIR 与字节 Seed):GPPO 用散度框架统一 PPO 类算法,自报比 GRPO 数学最多高 50%、代码最多高 14%。
来源与延伸阅读
- Google:Introducing Gemini 4 Argon · Artificial Analysis 评测 · VentureBeat · Argon 机器人版 · Argon 安全说明
- Meta:Muse Wonder · TechCrunch · Artificial Analysis · VentureBeat
- Anthropic:Distillation defenses · Preserved thinking 帮助文档 · Self-replicating AI
- Anthropic:Redesigning source control · The Register · Bloomberg:Q3 营收报道
- Codex 500k 默认上下文原帖 · GPT-6.1 Sol 文档
- WSJ:Amazon 洽购 Decart · Calcalist · GeekWire
- NVIDIA:Vera Rubin @ OCP · Run:ai 开源 · Google Earth AI
- morluto/rea · 木马事件分析 · gittested 评测
- Ollama v0.40.4 · ComfyUI v0.40.0 · anthropic-sdk-python v1.14.0 · openai-python v3.31.0 · openai-python v3.30.0
- LiquidAI/LFM2.5-24B-A2B · Liquid AI 博客 · microsoft/UserRepGen-4B · allenai/HiRO-ACEv2
- arXiv:2610.12822 · 2610.17637 · 2610.14423 · 2610.13015
今日行动建议
- API 选型团队:用限时价在自己的任务上跑 Argon,记录每任务输出 token,再按 12 月 1 日后的 4/20 美元重算成本。
- 把 Muse Wonder API 加进对比表,同时记住第三方评分更高的 Wonder Full 不对外开放 API。
- 用 Claude API 的团队:检查代码是否存储、修改或回传 thinking 块,确认账号创建时间是否在 8 月 31 日之后。
- 工程负责人:统计团队日合并量和 CI 耗时的趋势,提前评估 coding agent 放大提交量后的瓶颈。
- 想试 REA 的开发者:只从官方仓库、rea.tools 或 npm 包 rea-agents 安装,不要下载任何「独立 .exe」。
- 生产环境跑 Claude agent 的团队:升级 Anthropic SDK v1.14.0,把 OpenTelemetry 追踪接入现有监控。
- 做 RL 训练的研究者:读 GPPO 和多 agent 奖励作弊两篇论文,检查自己的多 agent 管线是否有作弊传染的路径。