一分钟速览
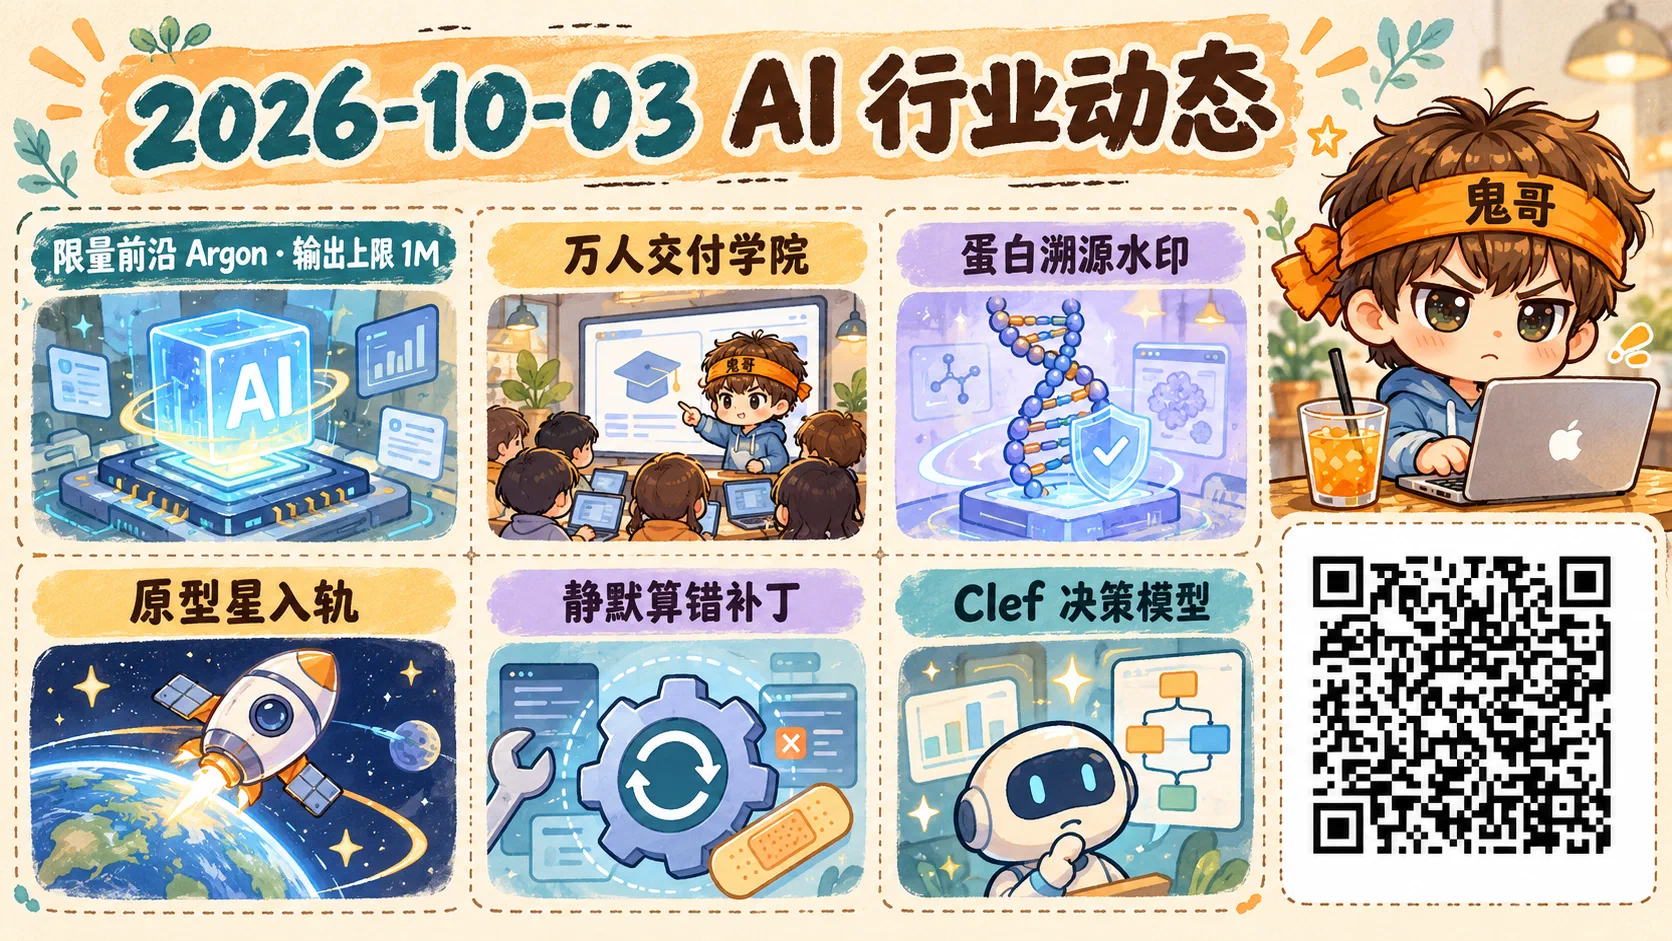
- Google 放出限量前沿 Gemini 4 Argon:先给 Fairwind 里受信任的网络防御方,官方称输出上限从 6.4 万拉到 100 万 token;导入价与基准均为官方自报,采购前待核。
- Anthropic 推出 Claude Frontier Academy:官方称投入 1 亿美元,目标到 2027 年底培养一万名能把 Claude 交进客户系统的驻场工程师——这是交付人才,不是新模型。
- DeepMind 发布 SynthID Bio,给 AI 设计的蛋白序列和预测结构加可核验水印(概念验证,不是筛查标准);Project Suncatcher 原型星已入轨,只记进展、不把项目本身再讲一遍。
- 开源栈一周:SGLang 0.5.21 让预填/解码热切换,Axolotl 0.20 与 Unsloth 桌面面板改微调出口,PyTorch 2.14.1 修 NVFP4 与 Mac 上的静默算错,MCP SDK 2.3 改了连上之后的默认行为。
- 模型侧没有新的大厂文本底座:Cloudflare Clef 把决策做成一次前向的选项概率;Qwen-Image 的少步蒸馏 viggle-turbo v0.3 权重落地。Edge0 只更新了说明,上期热卡没有新权重。
执行摘要
- Argon 是本窗唯一新前沿,而且先不公开:防御向限量,输出预算拉长;价与榜按官方称读。
- Frontier Academy 把竞争从模型榜挪到谁能把 agent 交进生产。
- SynthID Bio 是蛋白溯源概念验证,不是安全认证;Suncatcher 只新增「已入轨」。
- 开源:SGLang 热切换,GGUF 与 4-bit 微调,外加 PyTorch 静默算错补丁;MCP 2.3 会踩旧部署。
- Hub 新卡是 Clef;少步出图权重在 viggle v0.3。Edge0 与上期热卡不是新底座。
- Gemini Skills 将取代 Gems。同一权重换 harness,分差可以很大,百分比待核。
大厂与学术界动态
主线:Gemini 4 Argon——前沿先发给防御方,一条回复可以写到一百万 token
这意味着什么:本窗最大的模型新闻不是「又一个对所有人开放的旗舰」,而是 Google 把一款新前沿 先关在受信任的防御圈里。约 10 月 1 日 04:00(Asia/Singapore)的官方帖与博文宣布 Gemini 4 Argon:面向长程软件工程、企业知识工作(法律、金融一类)和防御向网络安全;先通过 Fairwind 计划给受信任的网络防御方,并参与美国政府自愿预发布流程,之后才打算扩到付费 API 和 Google AI Ultra。它不是全面可用。不要和仍无官方确认的「Gemini 4 Pro 泄露榜」合成「Gemini 4 已经公开」。
人话版:以前买前沿像走进已经开门的旗舰店;Argon 更像还在安检口的样机——能看、能给指定客户试用,柜台还没对所有人开。官方把输出上限从此前的 6.4 万 token 拉到 100 万。这和「上下文窗口有多大」不是同一句话:社交摘要有时把 1M 说成笼统的 token 上限,以博文的 output 为准。一条轨迹可以做很深的多步推理和很长的改动记录,而不是只把输入塞得更满。类比:上下文像办公桌有多大,输出上限像你允许助理一次交回来的文稿有多厚——Argon 加厚的是交回来的那一叠。
价格按官方称读,本窗没有独立核到价目表:导入期约每百万 token 输入 $2、输出 $10,缓存输入相对输入价再打约 95% 折;导入期结束后改为约 $4 / $20。这和上一窗几款 $2/$10 日常模型的导入价看起来同档,但 Argon 的访问面完全不同,不要按「同价就能下单」来排期。官方自报基准包括 DeepSWE v1.1 约 77.9%、AutomationBench 约 51.3%、LVBench 约 91.7%、CWE-bench v1 约 68%(自称领先或并列第一)。内部案例(量子子程序、机房内存、代码迁移)同样只是官方称,独立复现前不要写进合同。
访问政策里有一句需要单独听见、但不必展开成操作说明:对受信任防御方和 Google 内部团队,官方称会去掉网络安全护栏,以便用满防御能力。这是谁能拿到哪一档的政策,不是公开的攻击接口,也不是给读者的配置手册。对外读者该记住的是边界:你现在大概率还用不了;能用到的人是被点名的防御方;基准和内部案例都还停在「官方称」。
适用谁:安全策略、模型采购、要跟踪前沿访问面的平台团队。不适用:把 Argon 写进本周默认路由;把导入价当成已核对账单;用 CWE 一类分数反推可操作的攻击步骤;把泄露榜和这篇博文拼成已 GA 的 Gemini 4。
深入学习建议
- 精读 Gemini 4 Argon 博文 的发布范围、输出上限和价格阶梯,标出「现在谁能用 / 之后谁能用」。
- 采购表单另开一行「价与榜待核」:控制台或合同出现之前,不把
$2/$10或四项基准写进 SLA。 - 安全读者只记录访问政策的存在,不收集、不转述任何去掉护栏之后的具体做法。
主线:Claude Frontier Academy——下一轮短缺的不是模型名,是能把它交进生产的人
这意味着什么:Anthropic 本窗没有新模型。它花的是另一层预算——谁来把已经很强的模型装进客户的真实系统。10 月 2 日的 Claude Frontier Academy 官方称投入 1 亿美元,目标到 2027 年底培养 10,000 名 Frontier Deployed Engineer。路径像住院医,而不是发一张在线证书:多日线下面授,加上模拟企业部署考核,先拿 Resident 徽章;再在自己公司带一个真实 Claude 用例大约 12 周;通过后再考核,拿 FDE 徽章。首批证书预计 2027 年初。首期在旧金山、纽约、伦敦,由组织提名。首批由组织提名,点名了多家咨询、银行与药企。
人话版:模型榜像乐器考试,Academy 像教学医院。你不会因为考了高分就自动会做一台手术;企业也不会因为 API 里多了一个模型 id,就自动有人把权限、数据和值班接好。这个计划赌的是:接下来两年,瓶颈从「哪家分高」变成「谁家里有人能把 agent 交进生产并留下」。它不改变你今天的默认模型,但会改变咨询公司和大企业怎么报价、怎么派人。
和本窗 Argon 并读才完整:一边是前沿能力还在限量分发,一边是中端模型已经够用、缺的是交付编制。对纯研究团队,这条可以扫过;对正在签 Claude 企业单、或靠合作伙伴落地的团队,资格、考核和 12 周驻场比又一张基准表更值得读。数字(金额、人数、年份)都是官方称,合同与提名资格以新闻稿和项目页为准。细节以新闻稿为准。
适用谁:企业落地、合作伙伴、咨询与大客户成功。不适用:把它当成新模型发布;假设 2026 年内就能靠这张证书扩编;用「一万人」外推你们自己的招聘漏斗。
深入学习建议
- 先读 新闻稿,再读 项目页:记下提名制、城市、12 周驻场和两级徽章。
- 若你们靠集成商落地,问一句对方是否在首批提名里,以及驻场用例算不算进现有合同。
- 内部对照:你们缺的是模型路由,还是缺一个能对权限和评测负责的人。两条的预算不该混在一张表里。
主线:SynthID Bio——给 AI 设计的蛋白一个溯源层,不是一张安全证书
这意味着什么:当设计蛋白的模型变强,公开数据库和 DNA 合成筛查要回答的问题会从「这条序列像不像天然蛋白」变成「它是不是某个模型写出来的、能不能追溯到开发方」。约 9 月 30 日 23:00(Asia/Singapore),DeepMind 发布 SynthID Bio:把已有的 SynthID 水印思路用到合成生物设计上,在 AI 生成的蛋白序列和预测的三维结构里放一个不易察觉、可用密钥核验的签名。官方把它写成概念验证,面向数据库和合成筛查的溯源,不是已经部署的行业标准,也不是「能不能把蛋白做出来」的开关。
官方称,湿实验覆盖三个结合剂靶点(VEGF-A、SARS-CoV-2 刺突受体结合域、PD-L1),加水印的设计在命中率、结合亲和力和序列多样性上与未加水印版本相当,并称为首批既带水印又保持生物功能的结合剂。对 AlphaFold 3,官方称只微调扩散网络的一小部分,做到接近可检出、同时不伤预测精度。博文正文没有给出检出率百分比,也没有亲和力数值表,图表只被描述、没有可引用的 KD。这些句子一律按「官方称」读。
边界要说清楚,但停在影响、不进入做法:水印是治理工具。它帮助把设计关联到模型开发方,让合成服务有一个额外的溯源信号。它不是安全认证,不能替代筛查,也不能被理解成「加上之后就无法被改写」。公开科学报道讨论过这一局限(见 Nature 新闻)。本文只写它声称解决的溯源问题,不写实现,也不写任何针对水印或筛查的操作。类比:像纸币上的防伪线——它说明来源、方便抽查,不证明持有者没有别的意图,更不是一份「无法被仿造」的保证。
适用谁:生物安全、科学诚信、关心合成数据如何污染结构库的研究治理。不适用:把概念验证写成已上线的筛查 API;用「功能没有下降」替代你们自己的湿实验;把这篇博文当成水印实现说明书。
深入学习建议
- 读 DeepMind 博文 的目标、湿实验范围和作者自己写的局限,停在「它声称解决什么」。
X 动态
主线:Gemini Skills 取代 Gems——消费端把常用指令收成一条斜杠命令
这意味着什么:同一窗口里,Google 在聊天产品上做了一件和 Argon 完全不同的事——把「每次都要重新贴的自定义指令」收成可复用的 Skills。9 月 30 日的博文 Automate repetitive tasks with Skills 称,Gemini 聊天在全球上线 Skills:把常用指令存一次,在提示栏输入 / + 名字 再跑;可以叠多个 skill,也可以附 txt、PDF 和图片。Skills 将取代 Gems。个人账号大约从 2026 年 11 月起停用 Gems,Workspace 商业、企业和非营利大约到 2027 年 3 月,教育大约到 2027 年 6 月;现有 Gems 会迁移。实验性小应用 Opal 同步在 11 月关停。
人话版:Gems 像你自己钉在侧边栏的便利贴;Skills 更像聊天框里的快捷命令。差别不在模型变强,而在「重复劳动」有了明确的产品形态和下线时间表。类比:从「每次开会都口头重复同一段开场白」换成「输入斜杠调用一段固定脚本」。它和开发者文档里的 agent skills、插件规范不是同一条 API——消费端的斜杠指令,不会自动变成你服务端的工具契约。工程团队可以略读;负责 Gemini 企业租户的人应该把迁移月份写进变更日历,免得 11 月个人账号先断、第二年商业租户再断,两次都像意外。
适用谁:Gemini 产品负责人、Workspace 管理员、把 Gems 嵌进内部流程的团队。不适用:把它写成模型能力发布;假设 Skills 等于开发者侧的 MCP 或插件 SDK;忽略 Opal 关停对实验流程的影响。
深入学习建议
- 只读 官方博文 的迁移日期表,标出个人 / Workspace / 教育三条时间。
- 盘点你们还在用的 Gems:哪些能迁,哪些依赖即将关闭的 Opal。
- 和内部「技能」文档对一下名字,避免消费端 Skills 和工程 Skills 在工单里撞车。
主线:同一套权重,换一个脚手架,分数可以掉一半——榜分先别当成模型分
这意味着什么:评测讨论本窗最值得记住的一句,不是又一个总分第一,而是 Hugging Face 官方帖所称的 harness 分差。Harness 在这里指包着模型的那层脚手架:提示、工具、重试、解析和停止条件。帖子称同一套权重在一个 harness 里约 62%,换一个掉到约 33%,并说团队放出了 multi-harness 强化学习指南、材料开源。帖子时间约 10 月 2 日 22:51(Asia/Singapore),见 这条官方帖。
人话版:模型像发动机,harness 像变速箱和轮胎。只报发动机型号、不报装在哪辆车上,赛道圈速没有意义。若 62 和 33 站得住,采购和论文引用都不能只写「某模型在某榜多少分」——至少要写清脚手架。
置信度要压低。本窗没有钉死一篇与 62/33 一一对应的稳定长文。另有 9 月的预印本 2609.04518 讨论跨 harness 的信用分配,不要自动当成这篇帖的正文。百分比在对上长文之前标成官方帖自称、待核。不要把别的上下文论文自动当成这篇帖的正文。
适用谁:评测、RL、要在对外材料里写榜分的人。不适用:把 62 和 33 写进本周结论段;用这一帖否定所有基准;把未核对的指南仓库名写死。
深入学习建议
- 先看 HF 帖,再等它指向的长文或开源材料出现后核对百分比。
- 你们自己的榜:同一题集至少跑两个 harness,把分差写进报告,而不是只留最高分。
- 不要把 2609.04518 的方法直接说成这条帖的实现。
主线:BootLoops——科学问题要长得像「能复算的程序」,而不是像一段看起来对的散文
这意味着什么:本窗另一条被官方账号推开、但容易被 Academy 盖住的研究,是「AI 做科学」该接什么形状的任务。哈佛物理学家 Matthew Schwartz 在 Anthropic 客座文 What makes a problem Claude-shaped(约 10 月 1 日 22:02,Asia/Singapore)里主张:与其把大模型硬当成人类实验搭档,不如找可检验的精确计算。他发布的开源工具包 BootLoops(MIT)让 agent 去调用能复算的程序,而不是只交一段推导散文。站点写的接受标准是:图的完整函数形式已知,并且一台笔记本上的 Python 能算到任意精度。Anthropic 写明他曾是访问研究者,BootLoops 归 Schwartz 维护,不是 Anthropic 产品。手稿列表在 bootloops.ai/papers。
人话版:聊天模型很会写「看起来像论文」的段落;精确科学要的是「换一台机器还能算出同一个数」。BootLoops 像给科学 agent 发一台可审计的计算器,而不是再发一个更会说话的模型。36 篇手稿、18 个领域是作者自述,且多标 preliminary——不要当成已发表定理。类比:从让助理用散文描述一张电路图,改成让助理交出一份能跑的网表。
适用谁:科研工程、想把 agent 用在可复算任务上的实验室。不适用:把它写成 Claude 的新功能开关;用未发表手稿支撑对外科学结论;期待它覆盖实验湿实验室流程。
深入学习建议
- 读 客座文 的问题定义,再扫 手稿列表 看哪些标了 preliminary。
- 若要试用,先找一个「函数形式已知、笔记本可算」的小问题,而不是把整个课题丢进去。
- 引用时写清维护者不是 Anthropic 产品团队。
热门开源项目
主线:SGLang 0.5.21——预填和解码不用重启就能对调,前缀缓存默认走 Rust
这意味着什么:自建推理的人,本窗最厚的一份发布说明是 SGLang v0.5.21(约 10 月 2 日 09:09,Asia/Singapore)。它不是改一个小开关:发布说明写这版合入约 779 个 PR、约 227 位贡献者。对线上最有体感的两点,是预填/解码角色可以热切换,以及前缀缓存默认改走 Rust 核心。
人话版:分离式推理把「读长提示」和「一个字一个字往外吐」拆成两种机器。以前角色定错往往要重启;这版允许同一实例在 prefill 和 decode 之间换岗。前缀缓存默认改走 Rust 核心,热路径的默认实现变了,升级后要用自己的菜单对一次。
模型表接上了 DeepSeek-V4.1 Flash、MiMo-V2.6 以及一批多模态与扩散名。性能句是项目自测(长提示首 token、prefill 吞吐各有约两成的自称),上线前用自家提示长度复测。推理引擎接上旧底座,不等于今天发布了新权重。
适用谁:自建推理集群、做 PD 分离的平台。不适用:没看破坏性默认值就滚动升级;把 22% 写进容量规划;假设所有新模型名都有你们需要的量化与许可证。
深入学习建议
- 从 v0.5.21 发布说明 的 Key features 进对应 PR,先确认热切换和 Rust 前缀缓存的开关。
- 对照新模型表,只给你们真正在跑的检查点做冒烟。
主线:微调一周——训完能出 GGUF,4-bit 不必先撑爆显存,但 PyTorch 可能在悄悄算错
这意味着什么:训练侧本窗不是新算法,而是三条会改变「今晚能不能跑完」的发布叠在一起。约 9 月 30 日 22:08(Asia/Singapore)的 Axolotl v0.20.0 让 axolotl export 直接出 Q4_K_M、Q8_0 等 GGUF,给 llama.cpp、Ollama 或 LM Studio;长上下文可走上下文并行,并对带跨分片状态的循环层做了实验支持;还可在冻结的原生 NVFP4 基座上做 LoRA,合并结果与训练时的量化基座加适配器一致。最低要求升到 Python 3.12 和 torch 2.13.0,FSDP1 被移除。
Unsloth v0.1.902-beta(约 10 月 1 日 22:06)给桌面端加了命令面板,并让 NVFP4、INT4、MXFP4 在 LoRA 时保持 4-bit 打包,不再先展开成高显存副本。项目自测里,Qwen3.8-27B-NVFP4 在一张 RTX PRO 6000 上峰值约 40 GB 量级而不是约 73 GB。其余卡型的数字同样是自测,标签还带 beta,先在自己的卡上复测再相信。
同窗的 PyTorch 2.14.1(约 10 月 1 日 03:14)提醒:省下的显存如果算错了,比跑不动更危险。 这不是功能版。Linux 上 CUDA 13.2 的二进制升到 13.2.2,为的是修一类不报错却给出错结果的回归:NVFP4 矩阵乘可能忽略张量级缩放;另一项更早的编译器问题会在嵌套线程分歧时留下过期寄存器值。Mac 的 MPS 上,病态输入的 lstsq / svd 可能算错,元素一多还可能直接失败。细节以 CUDA 13.2.2 的发行说明为准。
人话版:Axolotl 像训完直接装进快递箱(GGUF);Unsloth 像不拆箱继续贴标签(4-bit 保持打包);PyTorch 补丁像发现秤在某些批次会静默少算。NVFP4 路径应该先对秤,再换箱子。
适用谁:要本地 GGUF、或在 Blackwell 上做 4-bit / NVFP4 LoRA 的人,以及在 Apple Silicon 上用线性代数的人。不适用:普通 CUDA 12.x 推理没走这些路径就优先升级;把 beta 显存写进采购;在未升 2.14.1 的 CUDA 13.2 上相信 NVFP4 乘积。
深入学习建议
- Axolotl:先读 导出文档 和 序列并行,确认 Python、torch 下限和 FSDP1 已移除。
- Unsloth:用自己的卡复测峰值显存;beta 别进无人值守生产。
- 路径上有 NVFP4 矩阵乘或 MPS 线性代数的,先升 PyTorch 2.14.1,用已知输入对照一次。
主线:库的默认行为变了——Transformers 接上新模态,MCP 连上之后不再容忍旧习惯
这意味着什么:应用层本窗的风险不在星标,而在升级之后原来能跑的连接会坏。Transformers 5.18.0(约 10 月 1 日 00:46,Asia/Singapore)把 Nemotron 3 说话人分离、NemotronH Omni,以及 HyperCLOVAX Vision V2、GTE 检索编码器接进正式库。说话人分离是流式开源权重,最多约八个说话人,同一检查点可从很短的缓冲调到约半分钟的离线缓冲。Omni 把 Mamba-Transformer 文本、视觉和可选音频合成一个自回归模型。破坏性改动包括 ROCm 上注意力实现更换,以及 vLLM 后端的视频 token 计数修正。隔天 PEFT 0.21.2 修了 5.18 及以上 encoder-decoder 不能用的问题——用 PEFT 的人要一起升。
MCP 的 Python SDK 2.3.0(约 10 月 3 日 06:02)和 TypeScript SDK 2.3.0(约 10 月 3 日 01:55)改的是连上之后的默认值。Python 侧:依赖下限提高;非法头部注解在注册时就失败;旧协议连接不再发送空的元数据和空参数,否则有的服务端会拒绝。TypeScript 侧:一个 Server 实例不能同时服务多个请求,无状态 HTTP 要每个请求新建服务和传输;客户端默认只跟随同源重定向,跨主机要显式允许。无状态网关和跨域跳转最容易坏。
人话版:Transformers 像配电箱多接了几路新电器,旧插座的接线也改了一点;MCP 2.3 像门禁升级——空包、一张门卡同时刷多扇门、跟着跳到另一栋楼,以前能过,现在会被拒。协议里没写出来的默认值,就是门的铰链方向。
热度旁证、不是框架发布:universal-modder 约 9 月 30 日新建,到 10 月 3 日上午大约 2100 star。它把编码 agent 的技能包收成游戏模组工作流。这里只记「垂直技能包可以在几天里热起来」。使用前自己确认授权;本文不评价具体做法。
适用谁:语音/多模态训练,以及 MCP 服务的维护者。不适用:把 star 写成技术结论;没读升级说明就在生产升 2.3;假设 5.18 对 PEFT 透明。
深入学习建议
- 先扫 Transformers 5.18.0 的破坏性改动;用 PEFT 则升到 0.21.2。
- MCP 两份升级说明在非生产网关先跑:无状态 HTTP、空参数、跨主机重定向。
- universal-modder 只扫目录结构,确认授权后再决定是否使用。
模型相关
主线:Cloudflare Clef——一次前向打出每个选项的概率,不再解析一段自由文本
这意味着什么:本窗 Hugging Face 上没有新的大厂文本底座。最硬的新卡是 Cloudflare 的决策模型 clef 与 clef-flash。创建时间约 10 月 1 日 05:15(Asia/Singapore),采集时点赞大约 782 / 260,下载大约 824 / 1303,许可证 Apache-2.0。卡面称:把「状态 + 一组带类型的问题」一次前向打成各选项概率,没有自由文本,也不做输出解析。Clef 的骨干标签是 Qwen3.8-27B,Clef-Flash 是 Qwen3.5-9B,另加一个 joint schema head。请求格式兼容 Jev / SystemOne。公告博客在 Clef decision models,榜在 Decision Index。
人话版:上一窗已经把「决策」从聊天副产品说成一个品类;这窗它落到了可下载的权重上。通用模型做分流,常常是写一段话再正则抠标签——偶发跑题,也难校准。Clef 像答题卡填涂机:选项事先定好,输出是概率。Flash 更小,适合先跑通。类比:闸机只回答「过 / 不过 / 有多确定」,不负责写一封解释邮件。
卡内「27B / 9B」、单次前向、H200 加特定 transformers 版本的运行条件,以及 Decision Index 全表分数和与 Jev、Laya 的对比,都还待核,不要直接引用表内分数。采集时另有一个对比项下载量为 0,不能当成已采用的对手。数据集 typed-decisions 本窗又有更新(点赞约 95,下载约 2.4 万),可当决策旁线,不是新数据集首发。
适用谁:路由、工单分诊、审核、要在 agent 里做稳定结构化判决的人。不适用:拿它当通用聊天;把榜上的延迟和准确率写进对外材料;忽略 Apache-2.0 以外、卡面运行条件未复现的部分。
深入学习建议
- 先读 clef-flash 把一条 Jev / SystemOne 格式的请求跑通,再决定要不要上 clef。
- 读 博客 的任务定义;Decision Index 分数先截图存档,复测后再引用。
- 和你们现有的解析式分类器比:同一批工单的校准和失败模式,而不只比平均分。
主线:少步出图的权重真的传上来了;端侧热卡多半只改了说明
这意味着什么:图像侧本窗要分清「文件写进仓库」和「README 被摸了一下」。Viggle/Qwen-Image-2.1-viggle-turbo 是对 Qwen-Image-2.1 的少步蒸馏。上一窗它还停在更早的修改时间;本窗提交大约在 10 月 1 日 10:44(Asia/Singapore)写入 v0.3 的 LoRA(r256 / r128)、合并后的单文件 transformer(GGUF Q4 到 Q8、fp8、int8)和 Comfy 工作流。采集时点赞约 538,下载约 24 万。许可证名是 qwen-research,不是通用商用默许。卡面把 v0.3 标成 9 月 29 日,但提交时间落在本窗——以提交为准,卡上的日期当标注。官方基座本窗只有「加反馈表」的文档提交,可部署的少步变体在 Viggle 这边。卡内「6 步相对基座 40 步、大约 5 倍、9 步模式大约 1.4 到 1.5 倍于 6 步」是仓库自称,画质和小字都待核。
对照着看,Edge0-35B-A3B-preview 本窗曝光很高(点赞约 3564,下载约 8 万),但创建于 9 月 8 日,本窗提交只有 README。说明文字写「9 月 30 日放出 iOS / macOS / Android / Windows 原生引擎」。这是叙事更新,不是新检查点。8B 预览同样只动了说明。卡内 3 GiB、15 tok/s、4-bit 等待核;引擎是否真有四端代码,要到 GitHub 看目录,不要从模型卡的句子直接下结论。
人话版:viggle 像货真的到了仓库月台;Edge0 像门口换了一块「四端都支持」的告示牌,货还是上个月的。上一窗的 MiMo-V2.6 MOPD、TeleOCR、Ming-flash-omni、GLM-5.3-Flash-NVFP4 的修改时间仍停在本窗之前,热度还在,但不是今日新权重,这里不展开。同窗还有一批只改了聊天模板或 README 的热卡,不要写成新版本。
适用谁:Comfy / 本地出图,以及端侧预算的人(后者只核对引擎,不换权重叙事)。不适用:把蒸馏倍数写进产品承诺;把 qwen-research 当成 Apache;把 Edge0 的 README 日期写成新模型发布日。
深入学习建议
- 出图:读 viggle-turbo 卡,用同一提示对比 6 步与基座,先看小字和结构,再谈速度。许可条款单独核。
- 端侧:打开 edge0 仓库 看四端目录是否真实存在,再决定要不要复测 tok/s。权重仍是预览,不是本周新发。
- 热度清单里凡是只有 README 或 chat template 的卡,默认降为次要,除非提交里出现新的权重文件。
次要动态
- Suncatcher 只记入轨。 约 10 月 2 日 07:30(Asia/Singapore),官方说明称与 Planet 合作的原型星已随 SpaceX Transporter-18 入轨并建立联系,状态符合预期,近几周收集发射应力、辐射和热环境数据;同行评议论文称已见于 Joule(本文没有单独的论文 URL)。项目本身上期已介绍,这里不重复「为什么要做轨道算力」。舱内芯片数量、功率和只能短时跑负载,来自媒体而非这篇官方正文,待核。仍是研究原型,不是可用云。
- 可证明隐私的联邦学习。 Google Research(约 10 月 2 日 22:57)称新系统用可信执行环境把匿名化做成可远程证明的保证,训练计算挪到服务端;Gboard 已采用,计算比旧联邦学习快,但没有倍数。论文 2609.31494。
- OpenAI 蒸馏披露,数字待核。 RSS 在窗内列出 Disrupting a coordinated model-distillation campaign(约 9 月 30 日 18:30):称已阻断一起针对受保护推理过程的对抗性蒸馏,不是数据库被入侵。正文页在采集环境返回拦截页,下列数字来自检索摘录、未能对上原文:约 7 月的活动、两天内上万次抽取模式请求、相关用户集群、以及与某实验室相关的个人。脚注据说计的是尝试次数而非确认成功。未打开原文之前,不引用具体次数和归属。
- arXiv 抽读(论文自报)。 2609.36054 多家实验室具名讨论「若 AI 自动化 AI 研发」的治理,脚注不代表机构,无新实验。2609.37725 把上下文当成可改写文件,论文报告更准也更省算力。2609.38415 是仿真评测:护栏关闭后越权比例更高,题目写明限制后次数下降;主比率不在摘要,本文不写做法。2609.36323 谈内部软件工厂效率。2609.36434 把安全指令强度当成旋钮,最佳工作点待核。
- 速度侧只留一句。 窗内没有新的速度档。公开表态称 Cerebras 仍是合作伙伴,以及 Sol 在负载下偏慢、后来应有改善。不要写成新的速度 SKU 或新合同。不要把它写成新合同。
- Hub 旁线,都不是新底座。 Phonon-2、FLUX 3 Action、Granite Speech、AstaBrief 本窗多是文档、计数或模板。PixelUMM 是新卡但几乎无下载、且非商用。社区 Uncensored 包不进选型。
- 上期热卡无新权重: MiMo MOPD、TeleOCR、Ming-flash-omni、GLM-5.3-Flash NVFP4 的修改时间仍在本窗之前。没有新的进展就不再当头条。
- 待核、不升主条: 会计月结「模型满分」、百科小版本和客服刷分转发,都没有打开到稳定长文。
来源与延伸阅读
- Google:Gemini 4 Argon · Skills · Suncatcher · 联邦学习
- DeepMind:SynthID Bio · Nature 新闻
- Anthropic:Frontier Academy · BootLoops 客座文
- OpenAI:蒸馏披露(原文未打开,数字勿引用)
- 模型与仓:Clef · SGLang 0.5.21 · Axolotl 0.20 · Unsloth beta · PyTorch 2.14.1 · Transformers 5.18 · MCP Python 2.3 · viggle-turbo
- 论文:2609.36054 · 2609.37725 · 2609.38415 · 2609.31494
- 讨论:HF harness 帖(百分比待核)
今日行动建议
- 访问面,不是默认路由: 为 Gemini 4 Argon 建一行跟踪(谁能用、输出上限、导入价何时变)。在官方控制台或合同出现前,不要把官方称的价格和四项基准写进对外材料。
- 交付编制单独记账: 读 Frontier Academy 的提名与 12 周驻场。问集成商是否在首批里。不要把这笔和模型 API 预算混为一谈。
- 生物设计只记溯源需求: 读 SynthID Bio 的目标与局限。把「设计能否追溯到开发方」写成筛查需求草稿。不要把它当成实现说明或已上线标准。
- 推理升级先复测: SGLang 0.5.21 只对你们在跑的模型做热切换冒烟,用自家提示长度核对首 token。不要照搬发布说明里的百分比。
- NVFP4 先修秤: 路径上有 NVFP4 矩阵乘或 Mac 线性代数的,升到 PyTorch 2.14.1 并做一次已知输入对照。然后再考虑 Axolotl 0.20 的 GGUF 导出或 Unsloth 的 4-bit 打包。beta 显存数字先在自己的卡上复测。
- 协议当破坏性变更: MCP SDK 2.3 在非生产网关上升级,重点测无状态 HTTP、空参数和跨主机重定向。Transformers 若升到 5.18,PEFT 同步到 0.21.2。
- 决策与出图分开试: 用 Clef-Flash 跑通一条结构化判决,分数先不引用。出图试用 viggle-turbo v0.3 时核 qwen-research 许可,并肉眼看小字。Edge0 只去仓库核对四端引擎,不要当新权重。
- 榜分写脚手架: 对外材料里的 agent 分数,至少注明 harness。HF 帖的 62 与 33 在长文出现前不要引用。OpenAI 蒸馏披露的次数和归属,在原文打开前不要引用。