一分钟速览
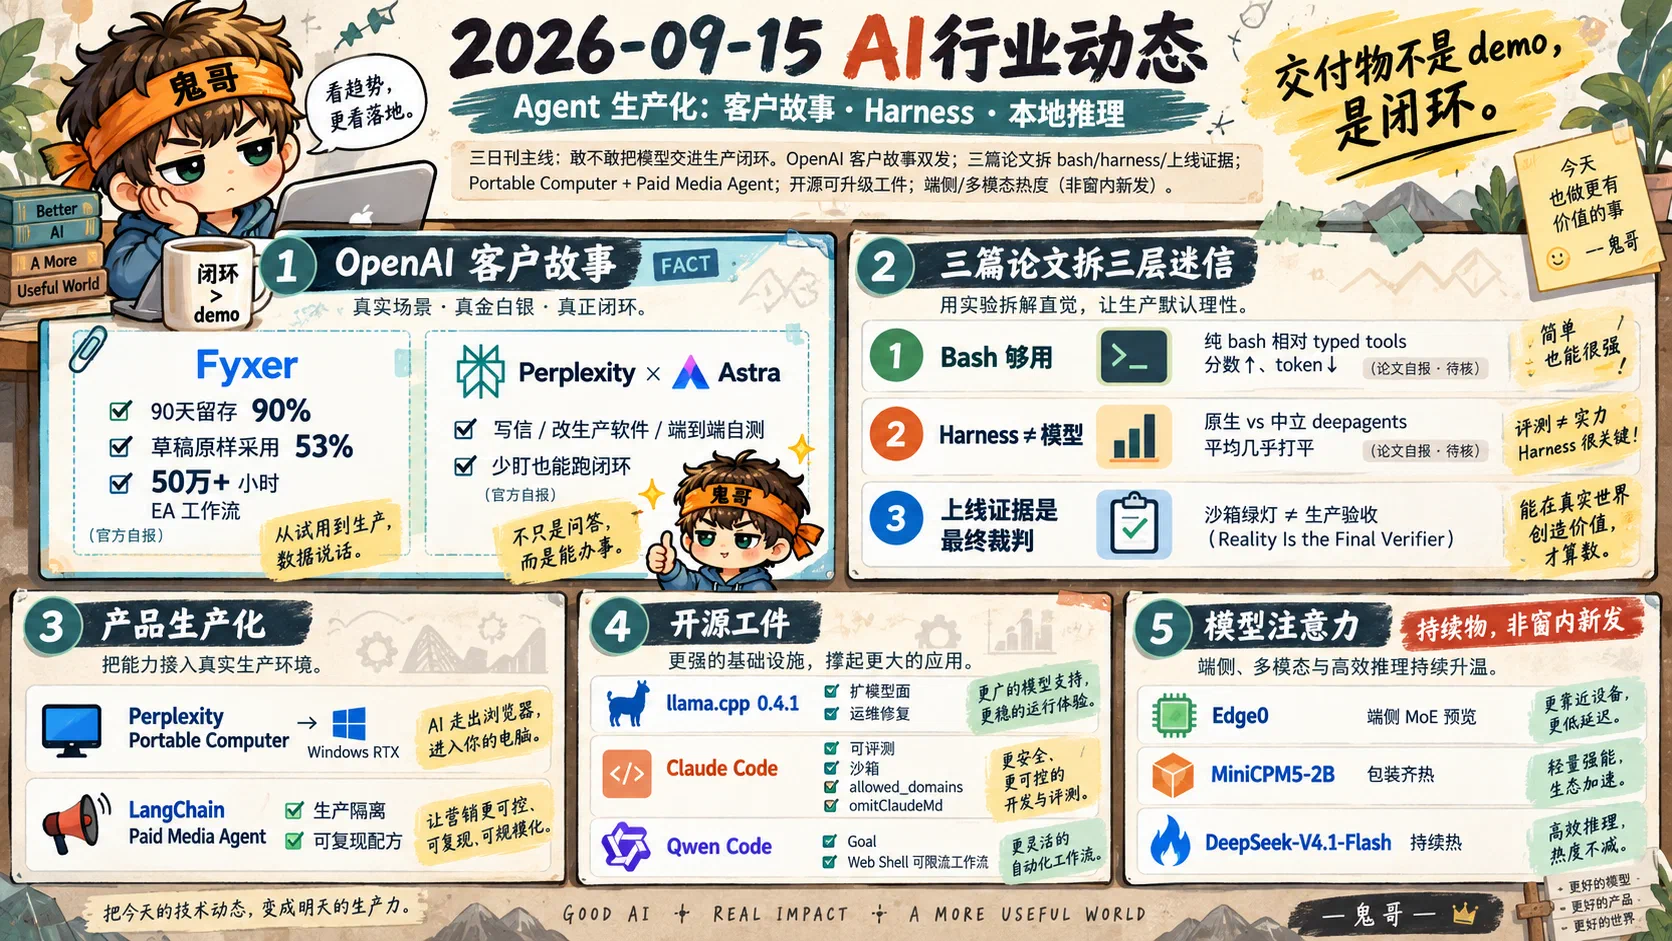
- OpenAI 同日放出两条客户故事:Fyxer 把行政助理做成「人敢用」的产品,Perplexity 则把 Astra 推进信、改生产软件与端到端自测闭环。
- 学术侧三条硬信号撞车:企业数字员工上「光 bash 往往够用」、厂商原生 harness 并非必然更强、上线证据才是最终裁判。
- 工程边栏:llama.cpp 0.4.1 扩模型面、Claude Code 加固可评测/沙箱、Qwen Code 把 Goal/Web Shell 做成可限流工作流。
- 产品侧:Perplexity 把 Portable Computer 推到 Windows RTX;LangChain 公开付费媒体 Deep Agent 的生产隔离与可复现配方。
- 模型注意力:Edge0 端侧 MoE 预览与 MiniCPM5-2B 包装齐热;DeepSeek-V4.1-Flash 仍居 Trending 中枢(勿写成窗内新发)。
执行摘要
- 本三日(Asia/Singapore · 09-12→09-15)无大厂基座扎堆;焦点是 生产闭环 与工具面 / harness / 上线证据。
- OpenAI 客户故事:Fyxer 行政助理(官方:90 天留存 90%、草稿原样采用 53%);Perplexity×Astra 写信/改生产/自测,少盯也能跑。
- 论文:纯 bash 常优于 typed tool 目录;原生 harness 并不稳赢中立编排;沙箱绿灯 ≠ 上线验收。
- 开源:llama.cpp 0.4.1 扩模型面;Claude Code 可评/白名单;Qwen Code Goal+Web Shell 可限流。
- 产品:Portable Computer 上 Windows RTX;Paid Media Agent 公开隔离与可复现。
- 模型:Edge0 / MiniCPM5 端侧升温;DeepSeek-V4.1-Flash 持续霸榜(非窗内新发)。
- 行动:先画三张对照表(bash vs typed、原生 vs 中立 harness、沙箱 vs 上线),再追数字或预览卡。
大厂与学术界动态
主线:OpenAI 客户故事双发——行政助理留存与 Astra 生产闭环
这意味着什么:大厂叙事正在从「模型又涨了几分」转向「客户敢不敢把关键流程交出去」。9 月 14 日 OpenAI 同日放出两条客户故事,一条讲信任与留存,一条讲端到端少盯——合在一起,像在告诉产品团队:交付物不是 demo,是可复用的工作流与可审计的自测闭环。
Fyxer 做的是 AI 行政助理(executive assistant)。人话版:不是再堆一个「帮你写邮件」的聊天框,而是把邮件与行政任务拆成多个专用专家模型,用接近真人声口的方式处理日程、跟进与草稿。依据 OpenAI 客户故事页,官方给出的数字是:90 天用户留存 90%;AI 草稿 53% 被原样采用;训练数据侧覆盖 500,000+ 小时 EA 工作流,并提到「数十个」专用模型。这些数字来自厂商客户故事,不是独立第三方审计——读法应是「他们愿意公开的产品健康指标」,而不是可直接写进融资材料的 benchmark。对做助理类 agent 的人,更有用的是结构:多专家拆分 + 海量真实流程数据 + 以「原样采用率」而不是「生成字数」当质量代理。
Perplexity × Astra 则把镜头对准「端到端系统」。依据 OpenAI 对应客户故事,Perplexity 用 Astra(GPT-6 一代里偏 agent/计算机使用能力的线)写通信、改生产软件、做端到端测试,并称比上代模型少盯很多。OpenAI 开发者账号同窗也呼应了 Astra+Codex 帮 Perplexity 测 harness 的叙事。人话类比:以前是请一个会写代码的实习生,你得盯着看他有没有改坏主站;现在更像请一个会写测试、会回传证据的承包商——你保留验收权,他把录像、截图或日志交回来。这不是独立公开榜单,是客户口述:重点在「敢把生产闭环交给模型」,而不在又一个代码补全分数。
适用谁:做 ToB 助理、客服、销售运营、搜索/研究产品的团队,应优先读这两页的「流程拆分与验收形态」,而不是抄数字;做评测的人,可把「原样采用率 / 少盯小时数 / 自测证据完整度」写进内部仪表盘。不适用:指望用客户故事替代自己的 golden set——那只会自我安慰。
深入学习建议
- 先读 Fyxer 客户故事,记下「留存 / 原样采用 / 工作流小时数」三项官方数字与多专家拆分结构。
- 再读 Perplexity × Astra,对照自己产品里「写代码」与「改生产 + 自测回证」差了哪一层。
- 若做 harness 评测,把「少盯」操作化成:人工介入次数、回滚次数、证据附件是否齐全。
主线:工具面、Harness 与上线证据——三篇论文拆开三层迷信
这意味着什么:Agent 工程这几天最响的学术信号,不是又一个总分榜,而是三层「默认假设」同时被打脸——企业场景未必需要巨型 typed tool 目录;厂商原生 harness 未必更强;沙箱绿灯 ≠ 上线可用。三篇可并列读成一条决策链:工具接口 → 外层编排 → 现实外环。
第一篇是 Microsoft 与 CMU 挂名的 Is Bash All You Need?。人话:给企业「数字员工」agent 选工具面时,一个通用 shell 往往比一堆精心声明类型的工具更好,还更省 token。论文在 TheAgentCompany 与 APEX-Agents 上对比五种接口(typed tools、typed+bash、纯 bash、bash+持久合成工具、程序化工具调用 PTC),报告纯 bash 相对 typed tools:TheAgentCompany 分数提升约 21.8–24.5 个百分点,APEX 约 +4.8–7.4 个百分点,总 token 少约 19–72%;给 bash 再叠 typed 或持久合成,池化分数未见可分辨增益。类比:给实习生一本 200 页的「只许按按钮」操作手册,不如给他一台装了 bash 的沙箱笔记本——前提是你真能把任意执行隔离开。论文建议:能隔离任意执行时偏 bash;合规强制固定工具目录时再考虑 PTC。这对 Copilot/企业工具目录的默认设计直接扎针。
第二篇是 Harness or Model?(evolutionID GmbH)。人话:同一模型换一层 harness(厂商原生 vs 中立 deepagents),平均解题率几乎打平;仓库题与竞赛题方向还相反。论文报告 Opus 4.8:原生约 48.8% vs 中立约 50.0%(约 −1.25pp);GPT-5.5 方向约 +1.25pp;仓库题原生落后约 9.0pp、竞赛题领先约 23.7pp;中立 harness 每解一题成本约 1.2–1.6×。类比:发动机差不多时,别迷信「原厂支架一定更跑分」——赛道不同,支架谁赢谁输会翻面。工程含义:选型要按题型拆,不要用「我们用了官方 harness」当质量背书;愿意付一点成本换可移植编排时,中立 harness 值得进 A/B。
第三篇是 Berkeley(Zaharia/Stoica 等)的 Reality Is the Final Verifier。人话:Agent 软件工程翻车,可归成「需求缺口」与「模型/评测环境缺口」两类;要用上线证据外环去补,而不是在沙箱里把 reward 刷绿就宣布胜利。类比:驾校科目二全绿,不等于上路不会刮保险杠——科目二是 harness,上路才是现实。这篇把 reward hacking、沙箱绿灯与生产事故合成一个框架,适合和前两篇串读:bash/harness 解决「怎么干」,现实外环解决「干完算不算数」。
适用谁:做企业 agent、工具目录、CI 评测与 SRE/发布门禁的人。不适用:把论文数字当跨模型永恒真理——题集、模型代数一变,Δ 会漂;先复现再决策。
深入学习建议
- 必读摘要与实验设定:2609.11999(bash vs typed)、2609.11987(harness)、2609.12039(上线外环)。
- 内部立刻做一张表:当前工具是 typed 还是 shell、harness 是否可替换、发布门禁是否含「生产证据」而非仅沙箱分。
- 次要可扫:AMDKernelVault(HIP/Triton 核数据)、AI Safety: Not Optional(多层安全设计)。
X 动态
主线:Perplexity Portable Computer 登陆 Windows RTX——本地「便携电脑」叙事落地
这意味着什么:搜索/研究产品正在把「云端问答」扩成「可带走的本地计算单元」。Perplexity 官方宣布 Portable Computer for Windows 到来,并强调 RTX 路径;官方博文见 Portable Computer for Windows is here,同步讨论见 相关动态。
人话版:以前 Perplexity 更像浏览器里的研究员;Portable Computer 更像给你一台「装了研究员操作系统的迷你电脑」——查询、文件、本地加速尽量收拢在一个可携带的产品形态里。Windows + RTX 的组合很直白:瞄准已经买了游戏/创作显卡、又想把推理留在本地的用户与小团队。它和同窗 OpenAI 客户故事里的 Astra 线形成对照:一边是云端强模型被交给生产闭环,一边是产品把能力「打包成可本地跑的电脑隐喻」。两者不互斥:云负责难推理与协作,本地负责隐私、延迟与离线可用。
适用场景:关心本地推理、隐私合规、Windows 创作机/游戏本二次利用的团队与个人开发者;想观察「AI 产品是否开始卖形态而不只卖聊天框」的产品经理。不适用:把博文当成全面 benchmark 报告——先核系统要求、模型来源、同步与计费边界,再决定是否进采购清单。
深入学习建议
- 读官方博文:Portable Computer for Windows is here,记下系统要求、RTX 相关能力与产品边界。
- 对照本站模型栏的端侧卡(Edge0 / MiniCPM5),想清楚「买产品形态」与「自建本地栈」哪条更适合你。
- 若做竞品跟踪,把 Portable Computer、本地 llama.cpp、云端 Astra 画成「延迟 / 隐私 / 能力上限」三角,避免混谈。
主线:LangChain Paid Media Agent——生产级隔离、工具发现与可复现
这意味着什么:Agent 开源圈这几天最值得跟的不是又一个玩具 demo,而是「付费媒体投放」这种真金白银场景,如何用 Deep Agent 做成可隔离、可发现工具、可复现的生产配方。LangChain 公开了生产复盘帖(讨论入口),并放出仓库 langchain-ai/paid-media-agent。
人话类比:投放 agent 不像写诗——点错一次预算就是钱。生产级做法通常要三件套:(1)隔离——凭证、账户、写出范围与实验环境切开,防止 agent「好心办坏事」改到正式广告账户;(2)工具发现——不要把上百个 API 一次性塞进上下文,按需发现与加载,降低串工具与幻觉调用;(3)可复现——同一输入能重放轨迹,方便审计「为什么那天多花了预算」。LangChain 把这套以付费媒体为样板摊开,价值在模板而不在「又一个垂直行业名词」。读帖时盯流程与失败模式,比盯营销形容词更有用。
适用谁:做营销自动化、投放优化、需要碰真实预算 API 的 agent 团队;以及任何要把 Deep Agent 从 demo 推进生产的工程负责人。仓库与帖子同属一条事件——本栏写生产叙事,开源类别不再复述,以免双计。不适用:无沙箱、无审计日志就直接对生产广告账户「放手让它跑」。
深入学习建议
- 先读 LangChain 公开复盘帖,提取隔离边界、工具发现与重放三点:status/2099543591139819742。
- 再打开仓库 paid-media-agent,对照自己的密钥与写出策略。
- 与大厂栏「上线证据外环」对照:投放日志与回放,就是 Reality Verifier 在营销场景的具体形态。
热门开源项目
主线:llama.cpp v0.4.1——本地推理「模型面」继续扩容
这意味着什么:本地推理栈的竞争力,越来越取决于「新架构隔周就能跑」,而不是「某次跑分第一」。llama.cpp v0.4.1(同步 ggml v0.24.0)在窗口内把 Maple 20B-A1B、Tencent Hy 4(hy_v4)、Spark2.5 等架构接进主线,并修一串真实会踩的坑:DeepSeek2/GLM-MoE 等 MTP 的 KV 分配、部分 Qwen/Kimi/GLM 的 GDN 归一化、多模态后 speculative 失败、server 子进程监控与 LRU 挂死等。
人话版:llama.cpp 像一台不断换刀头的万能刀——你不一定每天用新刀头,但社区模型一出来,刀头晚到一周和晚到一月,体验差很多。0.4.1 还把 JSON schema 收成内部 common_schema、聊天解析器拆到 common/parsers、加 --log-jsonl 结构化日志、用 --load-mode 正式取代已弃用的 --mmap/--mlock/--direct-io。对做本地服务的人,这些是可运维信号:日志能进采集、加载策略更清晰、路由子进程不那么玄学。Star 量级在素材快照时约 12.8 万——热度本身不是新闻,跟得上新架构才是。
适用场景:本地/边缘部署、GGUF 工作流、要在消费级显卡或 CPU 上追新开源模型的人。不适用:把 release notes 当模型质量榜——支持架构 ≠ 该模型已调优到可商用。
深入学习建议
- 读 v0.4.1 Release 的 New models / Core / Server 三段,标出你关心的架构是否已合并。
- 若跑 Qwen/Kimi/GLM/DeepSeek 系,优先核 GDN、MTP、multimodal+speculative 相关修复是否命中你的版本。
- 运维侧试开
--log-jsonl,把本地 server 日志接到现有观测栈做一次冒烟。
主线:Claude Code v2.1.271——插件可评、域名白名单与「可省略 CLAUDE.md」的子代理
这意味着什么:编码 agent 正在从「会改文件」升级成「插件可测、网络可白名单、子代理上下文可裁剪」。Claude Code v2.1.271(窗口内自 2.1.269 起连续点修)把此前方向落成更可运营的细节:plugin eval 体系延续、allowed_domains 收紧网络面、omitClaudeMd 允许自定义/插件子代理在 JSON 配置下不加载用户/项目/本地 CLAUDE.md(托管策略文件仍加载),并修大量 Bash 权限检查、组织策略缓存、云会话 schema 等生产向 bug。
人话类比:以前技能包像口口相传的菜谱;现在更像餐厅后厨——每道菜能出质检报告(eval),外卖只能送到白名单地址(allowed_domains),分店厨师不必把总店整本员工手册背进每一次短工单(omitClaudeMd)。这和 9 月中旬前后「技能 in-context vs 子 Agent」的选型讨论同构:子代理要干净上下文,就得有「哪些说明书不带进去」的开关;要进企业网,就得有域名闸门。Star 量级约 14.5 万——对使用者,版本号本身不如把 eval 报告接进 CI 重要。
适用谁:已在用 Claude Code 做插件/技能、需要企业网络策略、或要给子代理减负的团队。不适用:无视 Bash 权限修复、继续用过于宽松的通配命令——release 里大量修复说明边界情况仍多。
深入学习建议
- 打开 v2.1.271 Release,搜索
allowed_domains、omitClaudeMd、plugin eval三项,对照自己的 settings。 - 给 1–2 个关键插件跑通 eval,把 JSON/HTML 报告当合并门槛。
- 若跑云会话/组织策略,关注本版策略缓存与 MCP 控制相关修复,避免「换账号后仍用旧策略」。
主线:Qwen Code v0.23.4——Goal 自动开跑与 Web Shell 工作流成型
这意味着什么:开源编码助手赛道里,Qwen Code 把「目标(Goal)+ Web Shell」做成更接近产品工作台的形态,而不只是 CLI 补丁。v0.23.4 含破坏性变更(频道消息前缀过滤移除;read 命令 hook 超时改按秒),功能上让已批准的 Web Shell Goal 提案在所属 turn 结束后自动开跑;新增 model.goalMaxTurns / model.goalMaxActiveMinutes 限流;Web Shell 侧补齐预览面板、内联编辑重发、中断后续跑、通知带会话定位、上下文压缩与模型角色配置等。
人话版:Goal 像给助手一张「今日工单」,限 turn/限分钟像给工单加计时器;Web Shell 则是把终端、预览、会话、压缩按钮收进同一张工作台。破坏性变更提醒你:升级前先查频道策略与 hook 超时单位,别在周五傍晚裸升。Star 量级约 2.8 万——适合已经在 Qwen 生态里找「可自托管编码 agent」的团队做版本跟进。
适用场景:需要长程 Goal、浏览器内工作台、可配置上下文压缩的开发者。不适用:把自动开跑 Goal 当成无人值守生产发布——限流是刹车,不是免检通行证。
深入学习建议
- 读 v0.23.4 Release 的 Breaking Changes,再决定是否升级。
- 试用 Goal 限流两项参数,观察长任务是「跑完」还是「被分钟数掐断」。
- Web Shell 预览与 Continue execution:适合做前端/文档小迭代的回环,先在非关键仓练手。
模型相关
主线:端侧双热——Edge0-35B-A3B 预览与 MiniCPM5-2B 全家桶
这意味着什么:开源模型注意力正在从「又一张云端大卡」分出一条清晰支线——端侧可跑、包装齐全、MoE 少激活。窗口内两条信号最响:Edge0/Edge0-35B-A3B-preview 与 openbmb/MiniCPM5-2B(含 GGUF 等包装)。
Edge0 是面向端侧/边缘推理的 35B-A3B MoE 预览卡:总参数约 35B 量级,每次只激活约 3B,Apache-2.0,标签显示基于 Qwen3.6-35B-A3B 适配;约 9 月 14 日有更新并冲到 Trending 前列。素材快照时 likes 约两千、下载仍相对不多——典型「注意力强、落地量待观察」。人话:像一台名义排量大、平时只用小排量气缸的发动机,适合内存/算力紧但仍想要「大模型知识面」的边缘场景;预览卡意味着稳定性与授权链路要在生产前再核。
MiniCPM5-2B 是面壁的 2B 端侧小模型线,强调长上下文与工具调用;窗口内主卡与 GGUF/MLX/GPTQ/Base/SFT 等包装同步更新。素材快照时 likes 约 1.4k、downloads 约 20 万量级,可跑性信号强于纯话题热度。人话:这是「手机/笔记本也能试」的尺寸,优先官方主卡或 GGUF,别一上来追最花的量化名。
适用谁:端侧、本地、边缘 PoC;想用 MoE 少激活换体验的人先读 Edge0 卡,想要小而可工具调用先试 MiniCPM5。不适用:未核基座授权与预览稳定性就直接进生产;也别把 Trending 排名当成质量分数。
深入学习建议
- 读卡:Edge0-35B-A3B-preview、MiniCPM5-2B、MiniCPM5-2B-GGUF。
- 用 llama.cpp 0.4.1 或官方推荐路径做同机延迟/显存对照,再决定是否值得跟预览卡。
- 生产前单独核:基座许可、量化误差、工具调用模板是否与你的 harness 对齐。
主线:DeepSeek-V4.1-Flash 持续霸榜——注意力中枢,不是窗内新发
这意味着什么:三日刊必须交代「大家都在看什么」,但要分清「新发布」与「仍在发酵」。deepseek-ai/DeepSeek-V4.1-Flash 约在 2026-09-10 放出,本窗没有新的权重修订新闻;它仍居 Models Trending 前列,素材快照时 likes 约 2.5k、downloads 约 28.8 万,较 9 月 12 日早报继续爬升。模型定位是 DeepSeek 的 Flash 多模态线(能看图),MIT 许可。
人话:像一部上周五上映、这周一票房还在涨的电影——今天写进日报,是因为注意力与下载仍在抬,不是因为今天首映。跟进方式应是:读模型卡与社区适配(GGUF/llama.cpp/vLLM 等)进度,跑自己的图文与工具场景,而不是在标题里写「DeepSeek 今日发布」。大厂本三日几乎无新基座;V4.1-Flash 因此更像「开源多模态默认对照物」。
适用谁:跟 DeepSeek 线、需要开源多模态对照、做本地/API 双栈的人。不适用:把持续热度误读为窗内发版;也不要用下载量替代你自己的任务集。
深入学习建议
- 打开 模型卡,确认许可、模态与推荐推理设置。
- 与 Edge0/MiniCPM5 做「云/边/端」分工:Flash 偏多模态对照,Edge0 偏 MoE 端侧预览,MiniCPM5 偏小模型可跑性。
- 关注推理栈适配进度(含本窗 llama.cpp 修复面),再决定是否升本地版本。
次要动态
- AMDKernelVault(arXiv:2609.12471):AMD 开源 HIP/Triton 可执行核数据集 + agent 训小模型写核,减轻对前沿 LLM 写核循环的依赖——编译/GPU 方向选读。
- AI Safety: Not Optional, Not Later(arXiv:2609.10630):Bengio / CSIRO 等论证安全需多层设计(模型监督 + harness + 独立核验 + 治理),与本窗「上线外环」同读。
- Occamy-1.0 / SoK: Jailbreaking in Agentic AI:办公长程 agent 性价比与 agent 时代越狱综述,非大厂主料,摘要级即可(2609.11977、2609.12413)。
- anthropics/claude-for-financial-advisors:理财顾问 Cowork 插件新仓(仓库)——垂直插件样板,扫 README 即可。
- 热仓扫尾:ai-data-extractor(聊天史→JSONL)、recurrent-looped-tranformer / RLT、ToolReplay(tool-call 审计/重放)。
- XHToken/Spark-X2.5-4B、Agnes-3.0-Flash:社区小模型/多模态热度中等,轻量实验可扫,不宜当大厂基座替代。
- X 次要:Cloudflare Containers 自托管 Agents API、DeepMind WeatherNext 3、sama 关于失控 vs 集中的短帖——有信号但不够独立成主线。
- 官博静默:Anthropic / DeepMind / Meta / MSR 本窗无够格新官博;blog.google 软稿不抬。
来源与延伸阅读
- OpenAI:Fyxer · Perplexity × Astra
- arXiv:2609.11999 · 2609.11987 · 2609.12039 · 2609.12471 · 2609.10630
- Perplexity:Portable Computer for Windows
- X:LangChain Paid Media Agent · Perplexity 公告帖
- GitHub:llama.cpp v0.4.1 · Claude Code v2.1.271 · Qwen Code v0.23.4 · paid-media-agent · claude-for-financial-advisors
- Hugging Face:Edge0-35B-A3B-preview · MiniCPM5-2B · DeepSeek-V4.1-Flash
今日行动建议
- 产品/Agent:用 Fyxer 的「原样采用率」与 Perplexity 的「自测回证」改一版内部成功指标,少用「生成字数」。
- 工具面实验:在隔离沙箱对同一任务跑「纯 bash vs typed tools」各 10 条,记录分数与 token,对照 2609.11999。
- Harness A/B:挑 5 道仓库题 + 5 道竞赛题,原生 harness 与中立 harness 各跑一轮,看题型是否翻面(2609.11987)。
- 发布门禁:给编码 agent 加一条「上线证据」检查——日志/截图/回放至少一种,呼应 Reality Verifier。
- 本地栈:升级或试装 llama.cpp 0.4.1,确认你跟的架构(Hy4 / Spark2.5 / Maple 等)是否已支持。
- Claude Code:为关键插件接
plugin eval,并审一遍allowed_domains与子代理是否该omitClaudeMd。 - 端侧 PoC:MiniCPM5-2B-GGUF 做基线延迟;Edge0 预览卡只做读卡与小流量试推理,不直接切生产。
- 热度跟踪:DeepSeek-V4.1-Flash 继续当多模态对照物读卡,标题与对外沟通避免写成「今日新发」。